
باختصار: ما الذي نتحدث عنه أصلاً
في أغسطس 2026 ظهر على arXiv عمل بعنوان يكاد يكون روتينياً — «Software Defined Dataflow System for Large-scale AI Acceleration». وخلفه وصف لمسرّع Maia 200، وهو ليس تكراراً آخر من نوع «المزيد من الفلوبس لكل واط». الفكرة الرئيسية هنا معمارية: يقترح المؤلفون إعادة ترتيب الأولويات في طريقة تصميم شريحة الذكاء الاصطناعي أصلاً.
قُدِّم العمل في 25 أغسطس 2026 إلى قسم cs.AR، والمرسل هو تورستن هوفلر، ويضم قائمة المؤلفين 17 شخصاً (شيري شو وستة عشر باحثاً آخر). وقد صُنِّف العمل في عدة أقسام دفعة واحدة: المعماريات العتادية، والذكاء الاصطناعي، والحوسبة الموزعة والمتوازية، والتقنيات الجديدة، وتعلّم الآلة. أي أن الطرح ليس مذكرة «عتادية»، بل مفهوم يمسّ المنظومة بأكملها.
بيانات بدل أوامر: جوهر التحوّل
المسرّع التقليدي مبني حول تدفّق الأوامر. هناك أنوية، وهناك مُجدوِل، وهناك هرمية من الذواكر المؤقتة — وكل هذا البناء يخدم تنفيذ التعليمات. وتلعب الذاكرة في هذا النموذج دور الخدمة المساندة: وفّر البيانات في الوقت المناسب، ودع الباقي علينا.
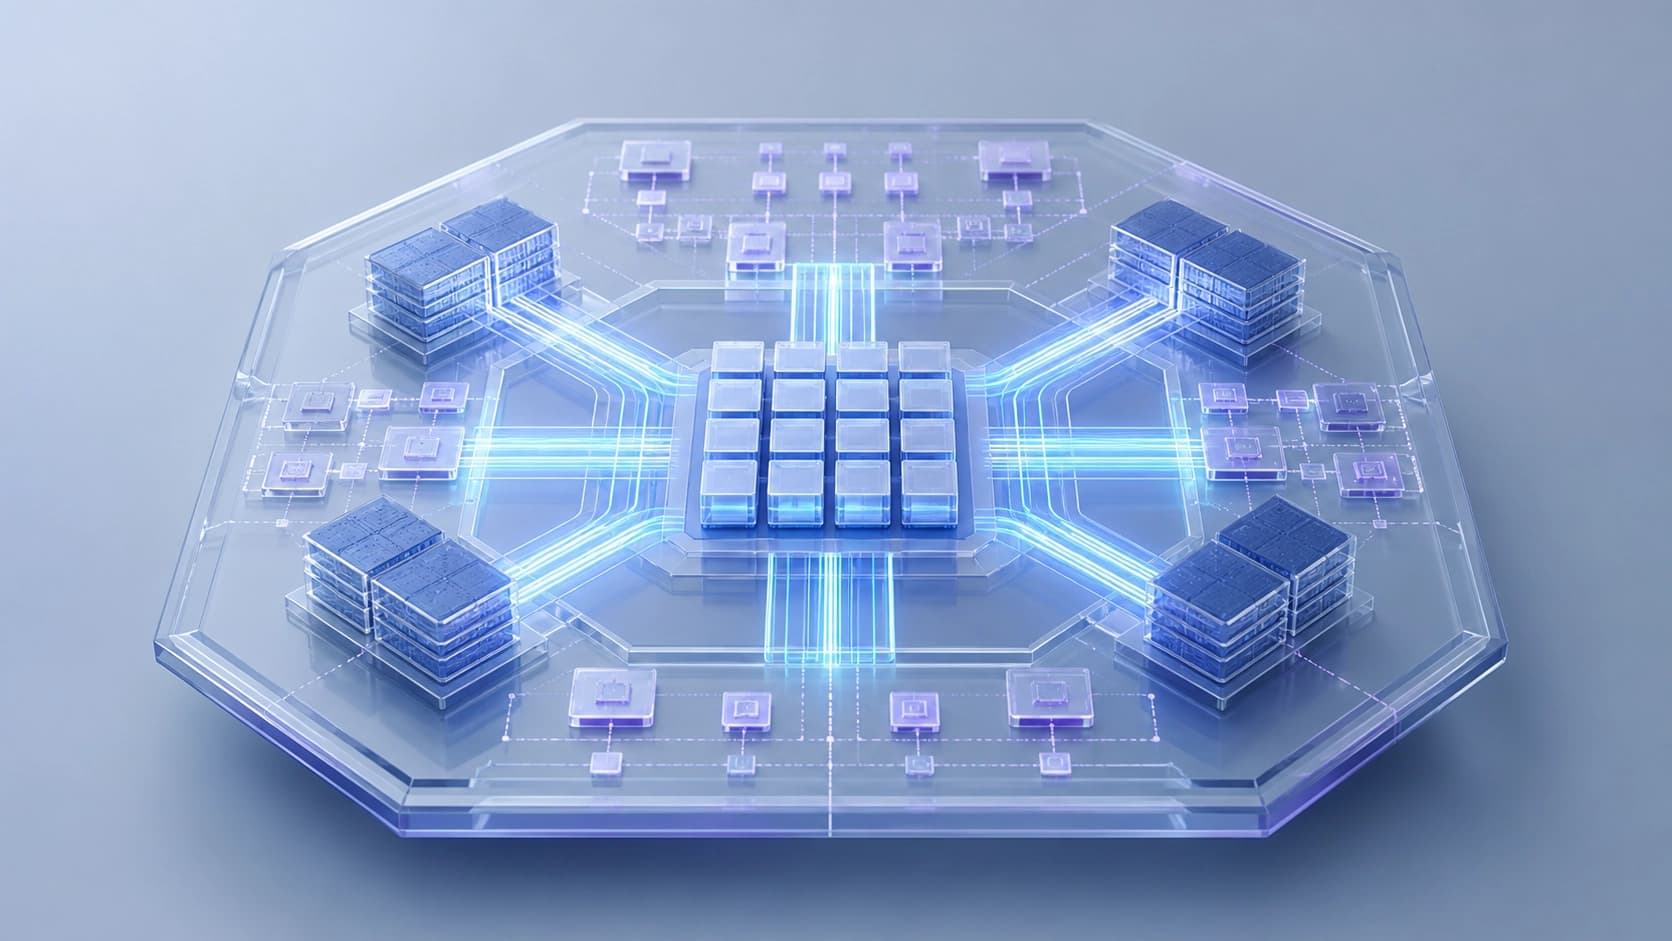
في Maia 200 ينقلب المنطق. يصنّف المؤلفون الشريحة ضمن فئة جديدة — Software Defined Locally Accessed Dataflow Architectures، واختصاراً SDLA. والكلمة المفتاحية هنا هي «software defined»: محرّكات تدفّق البيانات لا توجد في السيليكون فحسب، بل تُبرمَج صراحةً. يصف المبرمج كيف ينبغي تحديداً تنسيق كتل الذاكرة المتخصصة ومحرّكات نقل البيانات. فيصبح التحكم صريحاً، لا أثراً جانبياً لخط الأنابيب.
ومن هنا أيضاً انتقال التركيز: ليس محورياً حول الخيوط (thread-centric)، بل حول حركة البيانات (data-movement-centric). فسؤال «كم تعليمة في النبضة» يفسح المجال لسؤال «ما مدى سرعة وصول البيانات دون خسائر إلى حيث ستُحسب». وبالنسبة لأحمال العمل الحديثة، هذان طرحان مختلفان جوهرياً للمسألة.
الأرقام
الخصائص الجافة من الملخّص تبدو هكذا:
- 10 145 Tflop/s بصيغة FP4؛
- 5072 Tflop/s بصيغة FP8؛
- عرض النطاق الترددي للذاكرة HBM — 7 TB/s؛
- الحزمة الحرارية — 750 واط.
ماذا تعني هذه الأرقام — وماذا لا تعني
الإغراء بمقارنة 10 145 Tflop/s بصيغة FP4 فوراً بشيء مألوف كبير، لكن لا يوجد ما تُقارَن به بشكل سليم: فالمؤلفون لا ينشرون قياسات على نماذج محددة، كما أن صيغ الدقة المختلفة ومنهجيات القياس المختلفة تعطي أرقاماً غير قابلة للمقارنة. ويجدر الانتباه بشكل منفصل إلى أن الدقة المنخفضة جداً (FP4) هي دائماً حلّ وسط على حساب الجودة، وأن المكسب في الأرقام لا يساوي المكسب في العمل المفيد.
الأكثر إثارة للاهتمام هنا هو 7 TB/s. فهذه الخصيصة تحديداً تتناغم مع الفكرة الرئيسية للمقال: إذا كانت المعمارية مبنية حول نقل البيانات، فإن عرض النطاق الترددي للذاكرة ليس معاملاً ثانوياً، بل عنصراً إنشائياً حاملاً. أما 750 واط فهي تذكير بأن الحديث يدور حول رفّ خوادم، لا حول بطاقة مكتبية.
SDLA وتصنيف جديد
لشرح ما يميّز هذه الشريحة عن المعتاد، يبني المؤلفون تصنيفاً لإدارة البيانات. والمرجع له هو تصنيف فلين القديم، الذي كان يقسم الآلات حسب عدد تدفقات الأوامر والبيانات. كان ذلك لغة مريحة لعصر كان فيه عنق الزجاجة في التنفيذ.
أما الآن، وفق فكرة المؤلفين، فثمة حاجة إلى لغة أخرى — تتعلق بكيفية تصرّف النظام في البيانات. فيكون التصنيف ليس عن «كم»، بل عن «كيف يُنظَّم». وفي هذا الإطار تحتل SDLA خانة مستقلة: معمارية تكون فيها الذاكرة ونقل البيانات مواطنين من الدرجة الأولى، لا خلفية.
والمعنى العملي لهذا التصنيف ليس في حب المخططات. إنه يمنح المهندسين معجماً: يمكن الجدال بوعي حول الفئة التي ينتمي إليها عتاد معيّن والمهام التي تناسبه، بدلاً من قياس كل شيء برقم واحد.
لماذا هذا مهم للاستدلال
الاستدلال يتعلق في جوهره بتمرير كميات هائلة من الأوزان والتفعيلات عبر الشريحة بأقل تأخير ممكن. وكلما كبر النموذج، ارتطم كل شيء بقوة أكبر بالذاكرة وبالوصلات بين الكتل، لا بالحساب. وتُحدَّد الكفاءة هنا بمدى جودة النظام في تحريك البيانات.
يؤكد المؤلفون أن Maia 200 يحقق وفورات ملحوظة في التكلفة والطاقة، مع دعم التوازي الواسع تحديداً في أحمال الاستدلال. وإذا تأكد ذلك على مهام حقيقية، لا على بيانات اصطناعية فقط، فسيكون الحديث عن توازن آخر: ليس «أسرع شريحة»، بل «شريحة أرخص في الإطعام عند الحجم نفسه من الطلبات». وبالنسبة لمراكز البيانات، حيث الحساب بالميغاواط، فهذه تحديداً هي الحجة التي ترجّح الكفة.
ما بقي خارج الصورة
تقتضي الدقة بعض التحفظات. فالعمل هو نسخة أولية (preprint): arXiv:2608.24664، وDOI 10.48550/arXiv.2608.24664، وتتوفر نسخة PDF ونسخة HTML تجريبية والمصادر بصيغة TeX. أما التحكيم والقياسات المستقلة وإعادة إنتاج النتائج فما زالت في المستقبل. والوعود بشأن توفير الطاقة والمال ينبغي قراءتها كتصريح من المؤلفين، لا كواقع مقيس من طرف ثالث.
والسؤال الثاني هو كلفة الانتقال. فتدفّق البيانات القابل للبرمجة يتطلب طريقة تفكير مختلفة: على المطوّر أن يصف مسارات البيانات صراحةً، وعلى المترجمات والأطر أن تتعلّم كيفية الاستفادة من ذلك. وإلى أن تلحق المنظومة، لن تكون مزايا العتاد مرئية للجميع ولا فوراً. وهكذا كان الحال مع كل تحوّل معماري في المعالم: أولاً المفهوم، ثم الأدوات، ثم التبنّي الواسع.
ومع ذلك، فالأهم في هذه القصة ليس التيرافلوبس المحددة. الأهم هو الصياغة نفسها: عنق الزجاجة في حسابات الذكاء الاصطناعي انتقل إلى حيث تسافر البيانات، لا إلى حيث تُنفَّذ الأوامر. وإذا صحّت هذه الفكرة، فسيُصمَّم جيل الشرائح القادم بشكل مختلف — وربما يبدأ العدّ من هذا العمل تحديداً.


