الضرب القياسي كنقطة اختناق
تتقارب جميع معماريات الانتباه الحديثة تقريبًا في بنيتها: يُقارَن الاستعلام بالمفتاح عبر الضرب القياسي (أو نسخته المعيارية)، وتتحول النتيجة إلى أوزان، ثم يُجمَّع الخرج كمجموع مرجَّح للقيم. الحيلة عالمية، لكن لها ثمن — فالهندسة الخاصة بفضاء السمات في هذا المخطط محدَّدة بشكل صارم: تُقاس التشابهات «على استقامة»، دون مراعاة أن الاتجاهات المختلفة في الفضاء قد تحمل أهمية ومقياسًا مختلفين.
هذا القيد بالتحديد هو ما يستهدفه العمل arXiv:2608.24462 «Mahalanobis-Based Multi-Head Attention for Complex State Propagation» (المؤلف — Xiaohe Li؛ قسم cs.AI). فبدلًا من الضرب المعتاد، تُستخدم فيه نواة RBF المبنية على مسافة ماهالانوبيس. وبعبارة أبسط، لا يُحسب التشابه بين عناصر التسلسل «مباشرة»، بل مع تصحيح يراعي البنية التغايرية للبيانات — كما لو أن الفضاء قد مُدَّ وأُدير قليلًا قبل المقارنة، بحيث لا تُعد الاتجاهات المترابطة مستقلة.
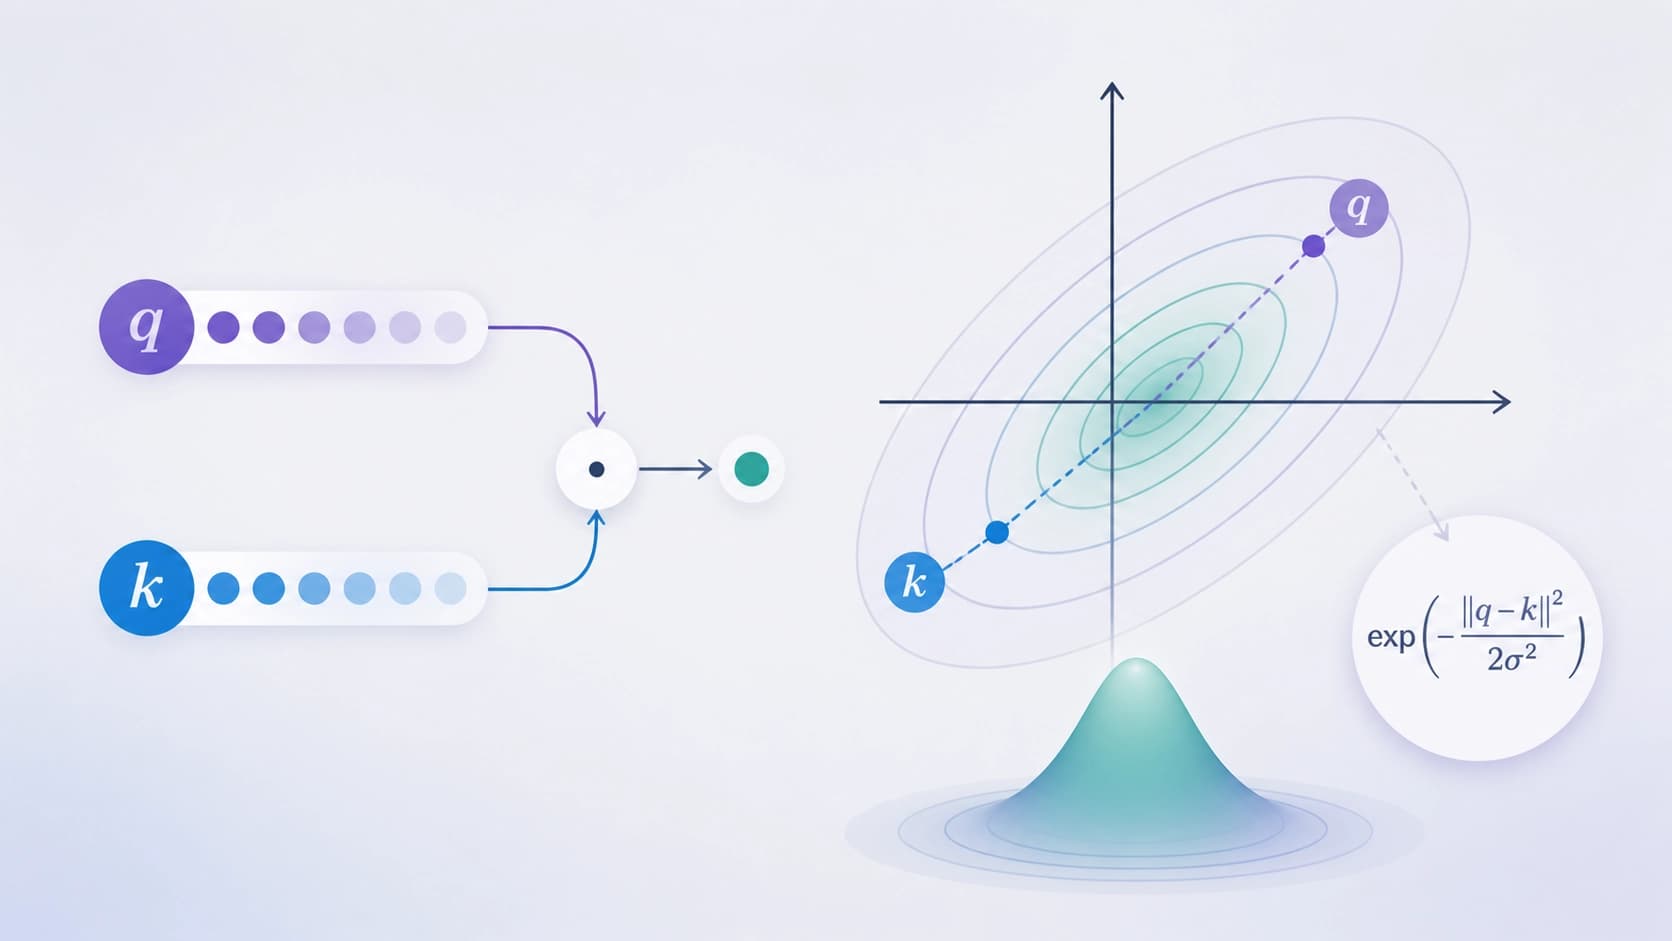
ما الذي تقدمه مسافة ماهالانوبيس
انتباه في فضاء لا نهائي الأبعاد دون نمو المعاملات
الادعاء المحوري للمؤلف: نواة RBF فوق مسافة ماهالانوبيس تتيح حساب الانتباه وكأنه يعيش في فضاء سمات لا نهائي الأبعاد، مع عدم نمو عدد المعاملات القابلة للتدريب. وهذا ليس سحرًا، بل نتيجة لكون النواة نفسها تحدِّد تخطيطًا غير خطي — فلا حاجة إلى طبقة منفصلة لفرد السمات. وعمليًا، يعني هذا متطلبات أكثر تواضعًا للذاكرة والتحسين، وهو ما يبدو شبه استفزازي في عصر النماذج العملاقة.
التحديد الموجب وTree Attention
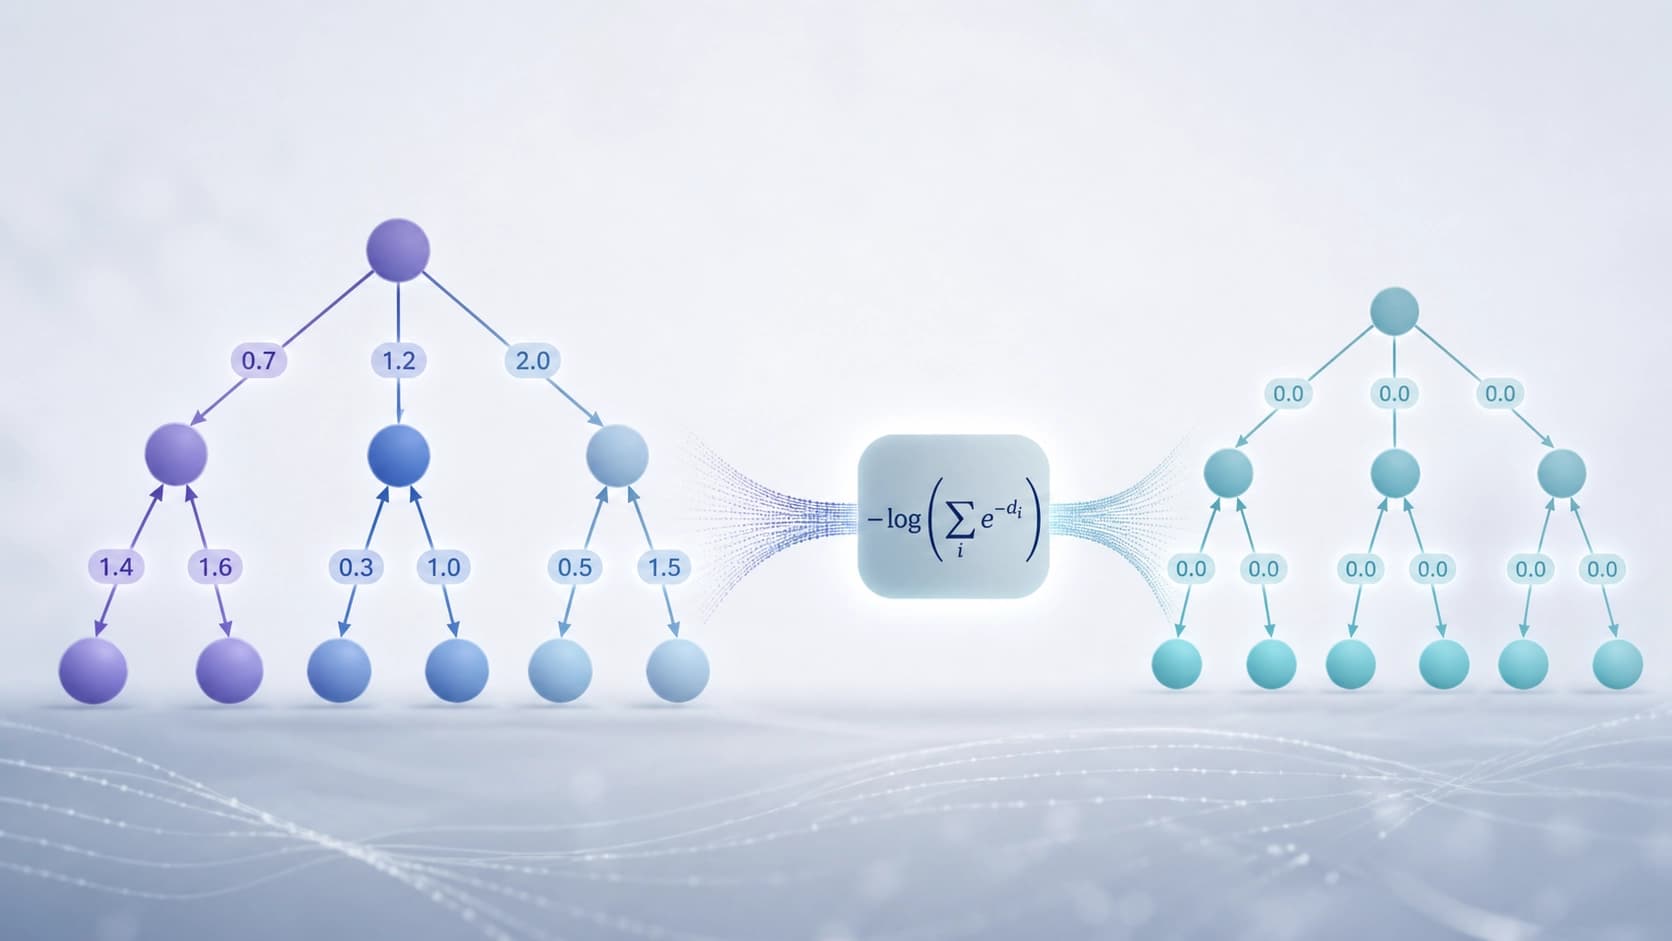
تستند الطبقة الثانية من الفكرة إلى خاصية رياضية لمسافة ماهالانوبيس: أنها موجبة التحديد. ومن هذا يمكن بناء ما يسميه المقال Tree Attention — إذ تُبنى تقديرات الانتباه لا من التشابهات «الخام»، بل من المسافات المتراكمة عبر الشجرة. ولكي لا تنحرف هذه التراكمات عدديًا، يُطبَّق تصحيح عبر LogSumExp: يُطرح من المسافة لوغاريتم مجموع الأُسّيات على الحواف. وهذا في جوهره طريقة للتوفيق بين مساهمات المسارات المختلفة في الشجرة دون فقدان وزنها النسبي.
وللقارئ غير المطّلع على التفاصيل، ثمّة تشبيه مفيد: بدلًا من جمع «التشابهات» كيفما اتفق، تعمل النموذج على تسويتها بعناية أثناء التوغل في عمق البنية. وهذا أقرب إلى المحاسبة منه إلى الحدس — لكن هذه الدقة تحديدًا هي ما يسمح للاستدلال بالبقاء مستقرًا على سلاسل التبعيات الطويلة.
Attention meshing: الرؤوس تبدأ بالتحاور فيما بينها
عادةً ما يُبنى الانتباه متعدد الرؤوس كمجموعة من الخبراء شبه المستقلين: كل رأس يحسب ما يخصه، ولا يحدث المزج إلا عند الخرج عبر إسقاط خطي. وفي MHA-CSP تُعاد استخدام مصفوفات مسافات ماهالانوبيس مرة أخرى — إذ يُبنى على أساسها آلية «attention meshing» التي تجعل نوى الرؤوس المختلفة تتفاعل مباشرة. ويعلن المؤلف فائدتين مزدوجتين: دقة أعلى، وتدريب أكثر كفاءة، لأن العمل الحسابي نفسه لا يتكرر.
التجارب: 119 ألف معامل في مواجهة النماذج الأساسية الكبيرة
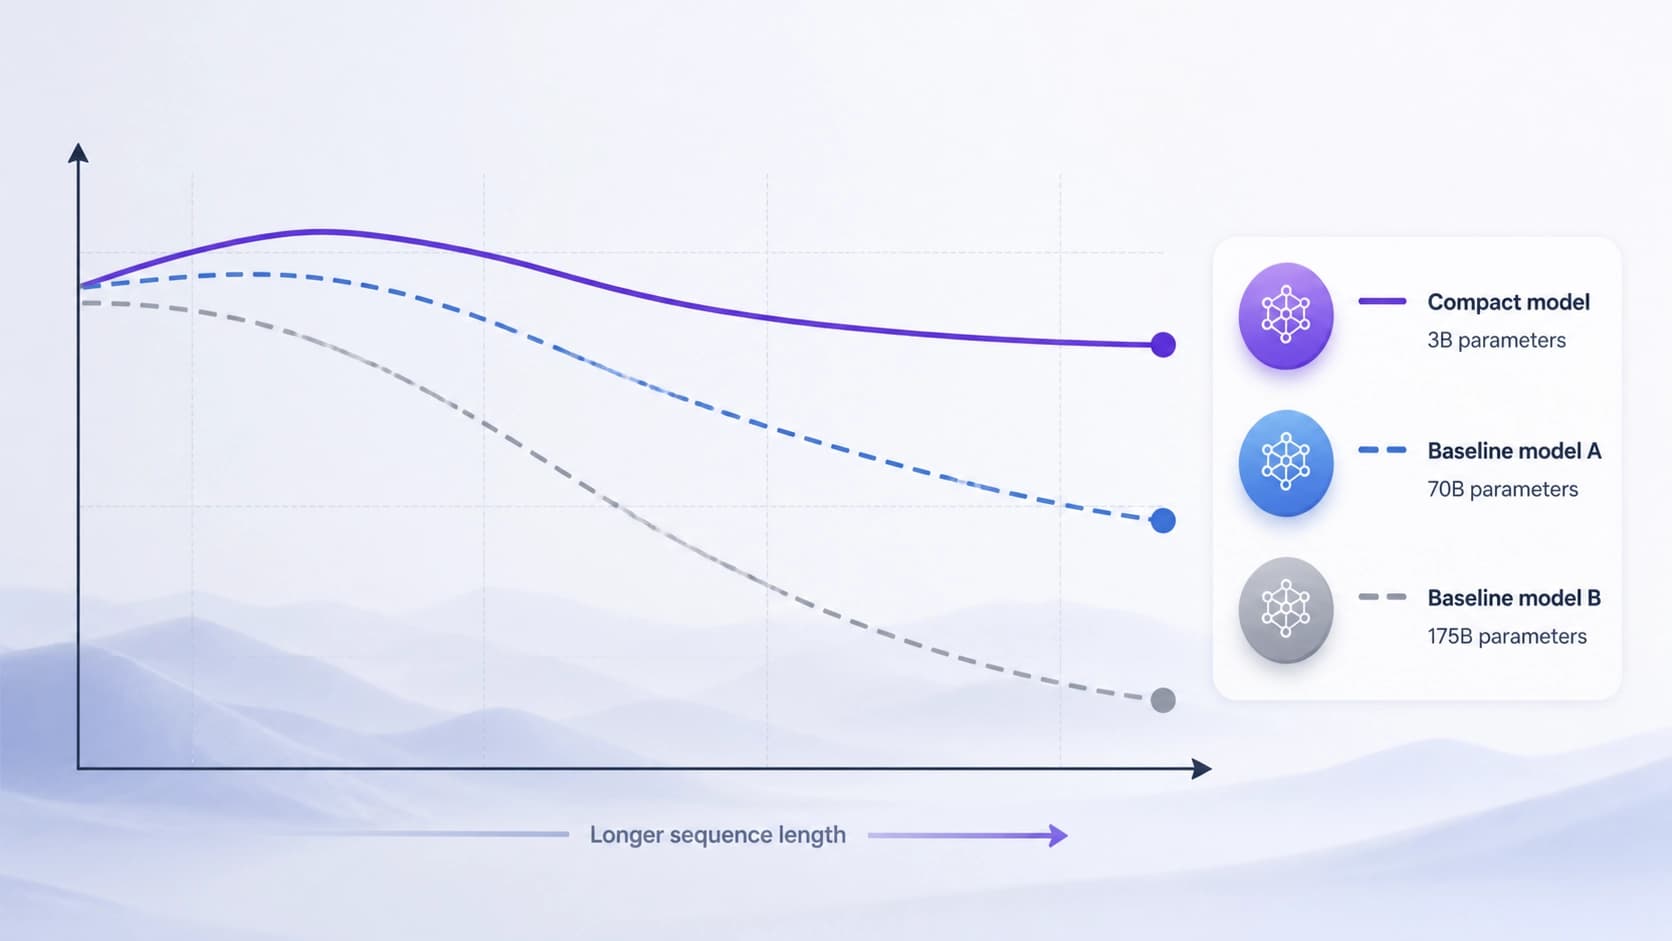
الجزء الأكثر إثارة في العمل هو المقارنة. يُقارَن MHA-CSP بـ 119 ألف معامل فقط مع محوّلات أساسية وشبكات التفاف رسومية دُرِّبت من الصفر في ظروف متطابقة. والمهمة هي تتبع الحالات على تسلسلات طويلة. بل إن teacher forcing طُبِّق حصريًا على الحالة المخفية النهائية، أي أن النموذج لم يتلقَّ تلميحات في كل خطوة، كما يُفعل غالبًا في التدريب الأكثر إفادة.
وبحسب ما يصرّح به المؤلف، يتفوق MHA-CSP بثبات على المنافسين. وتعتمد النماذج الأساسية إما على انتباه كثيف (المحوّل)، أو على نشر المعلومات عبر الرسم البياني (GCN)، بينما يحقق MHA-CSP استدلالًا مُهيكلًا عبر التصحيح التركيبي للمسافات والمرور الاقتصادي للمعلومات الموروث من backbone CSP.
ويجدر التأكيد: الحديث ليس عن أن نموذجًا صغيرًا «يلحق» بالنماذج الكبيرة في كل شيء. الحديث عن فئة محددة من المهام — تسلسلات طويلة ذات بنية رمزية داخلية، حيث المهم ليس مجرد تذكّر السياق، بل الحفاظ على حالته. وهناك تحديدًا تبدأ هندسة المسافات والتسوية الشجرية بالعمل.
ما الذي يغيّره هذا عمليًا
يُصاغ الاستنتاج الرئيسي للعمل على النحو التالي: إن نشر الحالات ذا القيم المركبة (complex-valued state propagation) مقترنًا بالتصحيح المشترك متعدد الرؤوس يثبت أنه أداة عملية لالتقاط البنى الرمزية. وهو يضع مقايضة جديدة بين الكفاءة والجودة لمهام الاستدلال المُهيكل.
وإذا نظرنا على نطاق أوسع، يتبدى هنا اتجاه السنوات الأخيرة: بدلًا من تكبير المعاملات، يبحث الباحثون عن تحيّزات استقرائية أكثر удача — أي يضعون في المعمارية افتراضات صحيحة حول طبيعة البيانات. كان الضرب القياسي افتراضًا مريحًا لكنه فجّ إلى حد ما. واستبداله بنواة ذات مقياس تغايري محاولة لقول النموذج: «ليست كل الاتجاهات في الفضاء متساوية، خذ ذلك في الحسبان منذ البداية».
نظرة حذرة من الخارج
ثمة أسباب تدعو إلى عدم التسرع في إعادة كتابة خطوط المعالجة. أولًا، النتائج مستخلصة على مجموعة محددة من مهام تتبع الحالات؛ ولا ينبغي نقلها إلى توليد النصوص أو الوسائط المتعددة أو السيناريوهات الحوارية دون تحقق منفصل — فلا وجود لتجارب كهذه في الملخص. ثانيًا، مؤلف واحد ونسخة أولى من المسودة (v1، قُدِّمت في 25 أغسطس 2026) يعنيان أننا لم نرَ بعد تكرارًا مستقلًا: الملف بحجم 377 كيلوبايت متاح بصيغ PDF وHTML ومصادر TeX، لكن إعادة الإنتاج قصة أخرى.
ومع ذلك يبدو الاتجاه مثمرًا. فالابتعاد عن الضرب القياسي، والعمل المباشر مع هندسة المسافات، وإعادة استخدام الحسابات بين الرؤوس — كلها خطوات تخفض كلفة النموذج دون التضحية بالتعبيرية. وإذا تأكدت النتائج في مجالات أخرى، فستكتسب الشبكات «الصغيرة لكن المصممة بشكل صحيح» حجة وجيهة أخرى.