
نهج LSem2Vec الجديد: كيف تحصل على تمثيل الكود في خطوتين وبدون تدريب مكلف
اقترح الباحثون طريقة بسيطة لتضمين الكود المصدري تجمع بين نماذج اللغة الكبيرة ونماذج تضمين النصوص. لا تتطلب طريقة LSem2Vec ضبطًا دقيقًا للمهمة، ووفقًا لنتائج التجارب، تتفوق على خمسة أساليب حديثة غير خاضعة للإشراف.
ما هي تضمينات الكود
التمثيل المتجهي للكود المصدري ضروري للعديد من المهام العملية: من البحث عن أجزاء متشابهة إلى التجميع التلقائي للدوال حسب المعنى. يتحول البرنامج إلى مجموعة أرقام يمكن لخوارزميات التعلم الآلي التعامل معها. وتعتمد جودة المتجه على مدى فهم النموذج لدلالات الكود، وليس فقط بناءه النحوي.
ما هي الصعوبة
الطرق التقليدية تتطلب عادةً تدريبًا منفصلًا لكل مهمة أو على الأقل ضبطًا إضافيًا على بيانات المجال. هذا مكلف وليس مبررًا دائمًا. الأساليب القائمة على النماذج اللغوية الكبيرة (LLM) تبدو أكثر عمومية، لكن لها عيبها الخاص: في إجابات النماذج غالبًا ما توجد معلومات زائدة أو خاطئة، وهذه "الشوائب" تدخل إلى المتجهات.
فكرة LSem2Vec
اقترح مؤلفو العمل نهجًا من مرحلتين باسم معبّر هو LSem2Vec — LLM-extracted code Semantics to Vector embedding. بدلاً من محاولة تدريب نموذج ثقيل آخر، يجمعون بين مكونات جاهزة: LLM يستخرج المعنى من الكود، ونموذج تضمين الجمل يحوّل الوصف إلى متجه. لا حاجة لضبط إضافي لمهمة محددة.
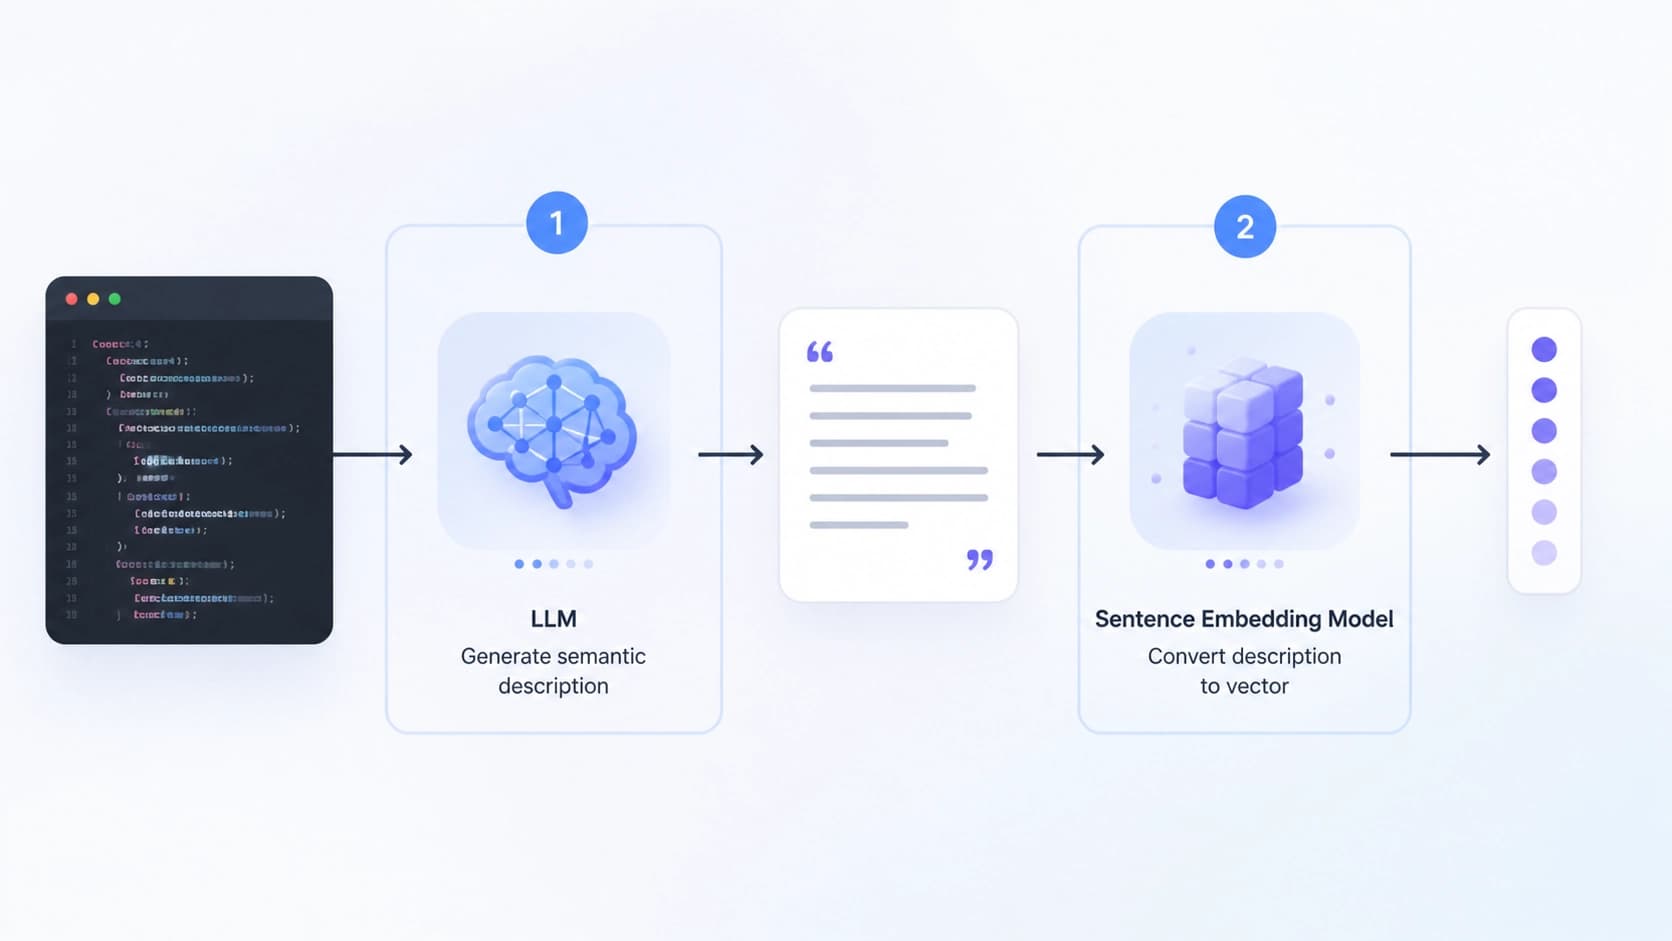
لنستعرض العملية خطوة بخطوة. في المرحلة الأولى، يتلقى LLM الكود ويجب أن يصوغ ما يفعله بالضبط. هذا ليس إعادة صياغة ميكانيكية للمصدر، بل استخلاص للجوهر: النموذج يتجاهل التفاصيل الثانوية بحيث يصل إلى الوصف فقط ما هو مهم للمعنى. وبالمقابل، يقطع هذا النهج أيضًا "تخيلات" النماذج الكبيرة المحتملة — المعلومات الخاطئة التي تظهر غالبًا عند محاولة ترميز الكود مباشرة.
المرحلة الثانية تافهة بمعايير التعلم الآلي: الوصف الذي حصلنا عليه من LLM يُمرَّر إلى نموذج تضمين الجمل. هذا النموذج مُدرَّب بالفعل على تحويل اللغة الطبيعية إلى متجهات ذات معنى، لذلك لا حاجة لتكييفه مع بناء جمل لغات البرمجة.
لماذا يعمل هذا
نقطة قوة LSem2Vec تكمن في الفصل الواضح للمسؤوليات. نموذج واحد مسؤول عن فهم المنطق، وآخر عن ترجمة النص إلى متجه. كل منهما يحل مهمته بأفضل طريقة، ومعًا يعطيان متجهًا مبنيًا على الدلالات وليس على السمات الشكلية للكود. غياب مرحلة التدريب يجعل النهج رخيصًا وسهل التكرار.
كيف تم التحقق وماذا كانت النتائج
أُجريت التجارب على ثلاث مجموعات بيانات مبنية بلغات برمجة مختلفة. غيّر المؤلفون عمدًا كلاً من LLM ونماذج التضمين للتأكد من أن النتيجة لا تعتمد على زوج أدوات محدد.
في جميع التكوينات، أظهر LSem2Vec نتائج أفضل من خمس طرق حديثة غير خاضعة للإشراف، والتي عادةً ما تكون مصممة لظروف محددة وتتطلب ضبطًا.
حالة العمل
نُشرت المقالة على arXiv في سبتمبر 2024، وآخر نسخة متاحة هي v5 من أغسطس 2026. وفقًا لمعلومات المؤلفين، قُبل العمل في مجلة Frontiers of Computer Science. هذا يعني أن النهج لم يعد له صفحة preprint فحسب، بل أيضًا منشور مُحكَّم. يمكن العثور على الأصل عبر DOI: 10.1007/s11704-026-61288-0.
الخلاصة
الاستنتاج الرئيسي من LSem2Vec هو أن المهام المعقدة لا تتطلب دائمًا حلولاً معقدة. يكفي تطبيق LLM لاستخلاص المعنى ونموذج تضمين الجمل لإنشاء المتجه بشكل تسلسلي. هذا سريع، دون ضبط خاص، ويعطي نتائج تنافسية.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
التحقق من هلوسات LLM عبر عرض المصادر باستخدام SQL، دون إعادة تدريب
تبحث الدراسة فيما إذا كان بإمكان نموذج لغوي كبير توظيف مهارة رمزية أساسية — إنشاء قاعدة بيانات SQL من المستندات المصدرية — للاستدلال على المصدر دون إشراف عند كشف الهلوسات. ويحقق هذا المسار العصبي الرمزي على مجموعتي RAGTruth وDiaHalu دقة أعلى من التنبؤ المباشر، ويضاهي أحدث الأساليب دون الحاجة إلى ضبط دقيق بحسب المجال.
9 نوفمبر 2026
MathAdv: ما الذي تخفيه الدقة النهائية للبراهين الآلية
تقيّم مجموعة مهام تشخيصية تغطي 13 فرعًا جامعيًا ودراسات عليا في الرياضيات أنظمة البرهنة الآلية في Lean 4، ليس من حيث النتيجة النهائية فحسب، بل أيضًا من حيث الإلمام بالمادة وجودة الاستدلال غير الرسمي والقدرة على التعامل مع إعادة صياغة الشروط. ويُظهر التحليل التفصيلي أن تحويل المسألة إلى صيغة رسمية لا يزال العقبة الأبرز، وأن النجاح يعتمد بشدة على فرع الرياضيات وطريقة صياغة المسألة.
9 نوفمبر 2026
AffordanceWAM: إمكانات الفعل كوسيط بين التنبؤ بالمشهد والتحكم في الذراع الروبوتية
يصف العمل نموذجًا توليديًا يتنبأ في الوقت نفسه بمشاهدات RGB المستقبلية والحقول العددية والخرائط الحرارية لإمكانات التفاعل، وبأوامر الروبوت المستمرة، مستفيدًا من مقاطع الفيديو البشرية لزيادة تنوع التفاعلات دون الحاجة إلى تعليقات توضيحية للأفعال أو إعادة استهدافها. وفي RoboCasa وCALVIN ABC→D والمهام الواقعية، يحقق هذا النهج تحسنًا ثابتًا مقارنةً بالخطوط الأساسية المعتمدة على RGB فقط أو على بيانات الروبوت فقط.
9 نوفمبر 2026