
كيف يجد التلقين الدقيق لنماذج اللغة الكبيرة البيانات الطبية المخفية التي تفوتها أنظمة إزالة الهوية القياسية
أظهر بحث جديد أن نماذج اللغة الكبيرة المزوّدة بتلميحات م calibrated خصيصًا لكل عيادة تسدّ الفجوات في حماية المعلومات الطبية — بما في ذلك الرموز الداخلية وأسماء المباني — متفوّقةً في الدقة على الخوارزميات الحالية، وكاشفةً في الوقت نفسه عن أخطاء في الترميز المرجعي.
لماذا تفوت أدوات إزالة الهوية القياسية البيانات "المحلية"
عادةً ما تتعامل أنظمة إزالة الهوية التلقائية للسجلات الطبية بشكل جيد مع الأنواع النمطية من المعلومات المحمية: الأسماء، تواريخ الميلاد، أرقام التأمين. لكن في المستشفى الحقيقي توجد بيانات تكون حساسة فقط داخل تلك المؤسسة. وهي الأسماء المختصرة للعيادات، وأسماء المباني، والرموز الداخلية للأقسام. بالنسبة للإنسان، تشير هذه السلاسل بوضوح إلى مكان العلاج، لكن الخوارزمية العامة لا يمكنها معرفة جميع التسميات المحلية.
تعتمد الحلول التقليدية إما على القواميس أو على نماذج مدربة بفئات ثابتة. وكلاهما يفوت ما لا يندرج ضمن قواميسهما. يطلق الباحثون على هذا اسم "المعلومات الصحية المحمية المترجمة مؤسسيًا"، وهنا تنشأ مخاطر جدية لتسرب البيانات.
كيف تنجح نماذج اللغة الكبيرة في سد الفجوة
للتحقق مما إذا كانت نماذج اللغة الكبيرة القادرة على التعلم السياقي قادرة على حل هذه المشكلة، أخذ مؤلفو التجربة 100 ملاحظة موسومة من أورام الأطفال — أي أكثر من خمسة آلاف جزء من المعلومات الصحية المحمية — ثم قارنوا ثمانية نماذج لغوية كبيرة بنظامين متخصصين (Stanford TiDE وOpenMed PII) وبخطين أساسيين قائمين على الأنماط.
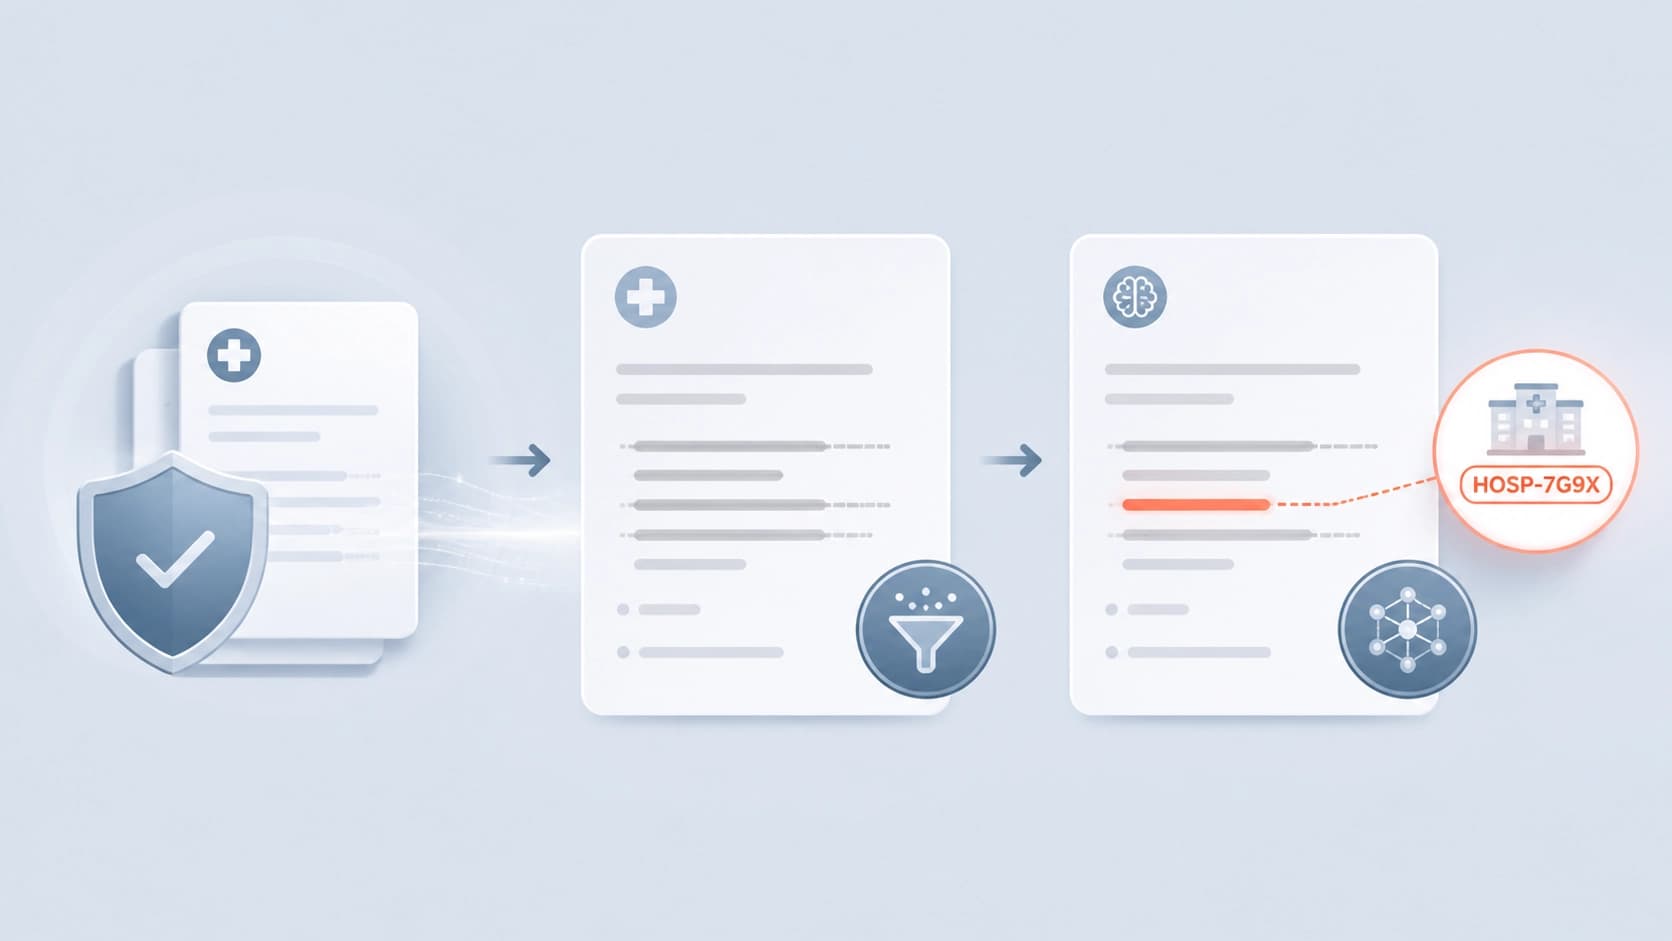
جاءت النتيجة لصالح نماذج اللغة الكبيرة: حقق أفضل نموذج F1 = 0.918 ± 0.001، بينما أظهر أفضل نظام متخصص TiDE 0.779 فقط. وكانت الميزة ملحوظة بشكل خاص في الفئات المعتمدة على السياق — وهي تلك التسميات المحلية التي عادةً ما تخرج عن نطاق رؤية الخوارزميات.
ثلاثة مستويات من التلقينات: من HIPAA إلى الضبط الدقيق
الأسلوب الأساسي ليس مجرد طلب، بل ضبط موجه للتلقين خصيصًا للمؤسسة المعنية. استُخدمت في التجربة ثلاثة أشكال:
- تلقين أساسي — تعليمات عامة وفق معيار HIPAA.
- تلقين بالفئات المحلية — يُضاف قائمة بأنواع المعلومات الصحية المحمية المؤسسية التي لا يأخذها المعيار في الاعتبار.
- تلقين مع حماية من التحرير المفرط — توجيه إضافي بعدم قص محتوى سريري زائد.
استعادة سرد الفئات المفقودة 79% من أصل 61 جزءًا لم يُعثر عليها سابقًا (48 قطعة). أما التعليمات ضد التحرير المفرط فأعادت الدقة التي كانت تتأثر بسبب "التحوط الزائد" من النموذج.
الوكلاء والمجموعات لم يحققوا مكسبًا
يمكن الافتراض أن تشغيل عدة نماذج أو مخطط متعدد الوكلاء سيعطي نتيجة أفضل. اختبر المؤلفون 14 تكوينًا من هذا القبيل وقارنوها بأفضل تلقين فردي. اتضح أنه لا توجد أي بنية وكيلة تفوقت على مجرد تلقين معاير بمرور واحد. لدى الوكلاء، بقي F1 في نطاق 0.906–0.907 — أي عمليًا عند نفس المستوى، لكن دون مكسب إضافي.
نماذج اللغة الكبيرة كمدققة للوسوم
القيمة الإضافية لمنهج نماذج اللغة الكبيرة هي أنها تساعد في التحقق من جودة المجموعة المرجعية نفسها. أشارت النماذج إلى 414 موضعًا حيث كان الوسم الأصلي على الأرجح غير مكتمل. بعد الفحص اليدوي، تأكدت 227 فترة معلومات محمية مفقودة. عندما صُحح الوسم وأُعيد تشغيل التلقين، ارتفع الاستدعاء إلى 0.981 مع F1 = 0.907 ± 0.002. هذا يعني أن نماذج اللغة الكبيرة يمكن أن تعمل ليس فقط كأداة لإزالة الهوية، بل أيضًا كمدققة لإنشاء مجموعات تدريب أكثر دقة.
الاستنتاجات
يسمح التلقين المضبوط جيدًا لنماذج اللغة الكبيرة بسد الفجوة المؤسسية في المعلومات الصحية المحمية وإيجاد التوازن الأمثل بين الدقة والاستدعاء في استدعاء واحد للنموذج. هذه الطريقة أغلى من الأساليب المعجمية التقليدية، لكن هذه التكاليف تُعوَّض جزئيًا بإمكانية التحقق من المرجع نفسه وتحسينه.
يرى المؤلفون أن نماذج اللغة الكبيرة بديل مشروع وقابل للتكيف للأدوات المتخصصة في إزالة الهوية. الاستراتيجية الرئيسية للتنفيذ هي تطوير تلقينات خاصة بكل مؤسسة تراعي الواقع المحلي لكل عيادة.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
اختبار وكلاء البرمجة في تطوير XR التفاعلي: نتائج GenXR-Bench
نُشرت GenXR-Bench، وهي مجموعة تضم 112 مهمة من إعداد خبراء لتقييم وكلاء البرمجة تقييمًا شاملًا في تطوير XR التفاعلي، بدءًا من تحسين الوظائف وإصلاح العيوب وصولًا إلى إنشاء التطبيقات والتحقق من سلوكها على أجهزة استهلاكية. حقق أفضل أداء بين النماذج العشرة التي خضعت للاختبار 50.9% Pass@1؛ وشملت الإخفاقات المتكررة التعامل مع الأحداث غير المتزامنة للمستشعرات، وربط الكائنات بالفضاء الواقعي، وفهم التفاعل في السياق المادي.
5 نوفمبر 2026
من المكافأة القياسية إلى جبهة باريتو: توليف RTL باستخدام النماذج اللغوية الكبيرة والتعلّم المعزّز متعدد المعايير
اقتُرحت طريقة لتدريب نموذج لغوي على توليد مجموعة من مرشّحات RTL بدلًا من مخطط واحد، مع مفاضلات مختلفة بين المساحة وزمن التأخير واستهلاك الطاقة؛ وتُبنى المكافأة على مساهمة كل خيار في حجم فرط جبهة باريتو. على RTLLM v2، ارتفع حجم فرط باريتو النسبي بمقدار 13.3 نقطة مئوية مقارنةً بالإصدار الأساسي من دون تحسين PPA، وبمقدار 14.4 نقطة مئوية مقارنةً بالتدريب بالتعلّم المعزّز ذي الهدف الواحد.
5 نوفمبر 2026
تتعرّف النماذج اللغوية الكبيرة الطبية على تحديثات التوصيات، لكنها غالبًا ما تجيب وفقًا للإرشادات القديمة
أظهرت دراسة ChronoEvo التي شملت 1709 تغييرات في التوصيات السريرية أن النموذج الأساسي رصد التحديث في 90,8% من الإجابات، لكنه طبّقه بالكامل في 58,5% فقط، وظلت فجوة قدرها 32,3 نقطة مئوية قائمة لدى 14 نموذجًا. وحتى تعزيز بروز التحديثات لم يحقق زيادة ملحوظة في التطبيق الكامل للقواعد الجديدة ضمن التوصيات السريرية.
4 نوفمبر 2026