باختصار: المشكلة ليست في اللغة، بل في الكتابة
جرت العادة على تقييم مرشّحات الحماية في النماذج اللغوية الكبيرة باللغة الإنجليزية. ومن هنا تنشأ وهم مريح: إذا كان النموذج يلتقط بثقة الإهانات والدعوات إلى العنف في النص الإنجليزي، فسيتعامل مع اللغات الأخرى بالطريقة نفسها تقريبًا. أما الأردية — لغة يتحدثها نحو 246 مليون شخص، وهي العاشرة عالميًا بهذا المعيار — فلا تكاد تدخل في هذا الفحص. واتضح أن لهذه الفجوة ثمنًا قابلًا للقياس.
ويتناول ذلك عمل حديث بالمعرّف arXiv:2608.24191. وعنوانه «Ghaib in Translation» يلعب على كلمة ghaib التي تعني في الأردية «الخفيّ، غير المرئي»: فالحديث يدور عن ضرر يبقى دون أن يلاحظه أحد. والمؤلفون هم Fawzia Zehra (Fuzzy) Kara-Isitt وSonal Khosla وStephen Swift. ظهرت النسخة الأولى في 25 أغسطس 2026، والمراجعة المحدّثة في 9 سبتمبر من العام نفسه؛ وتنتمي المقالة إلى مجالي cs.CL وcs.AI، وDOI هو 10.48550/arXiv.2608.24191.
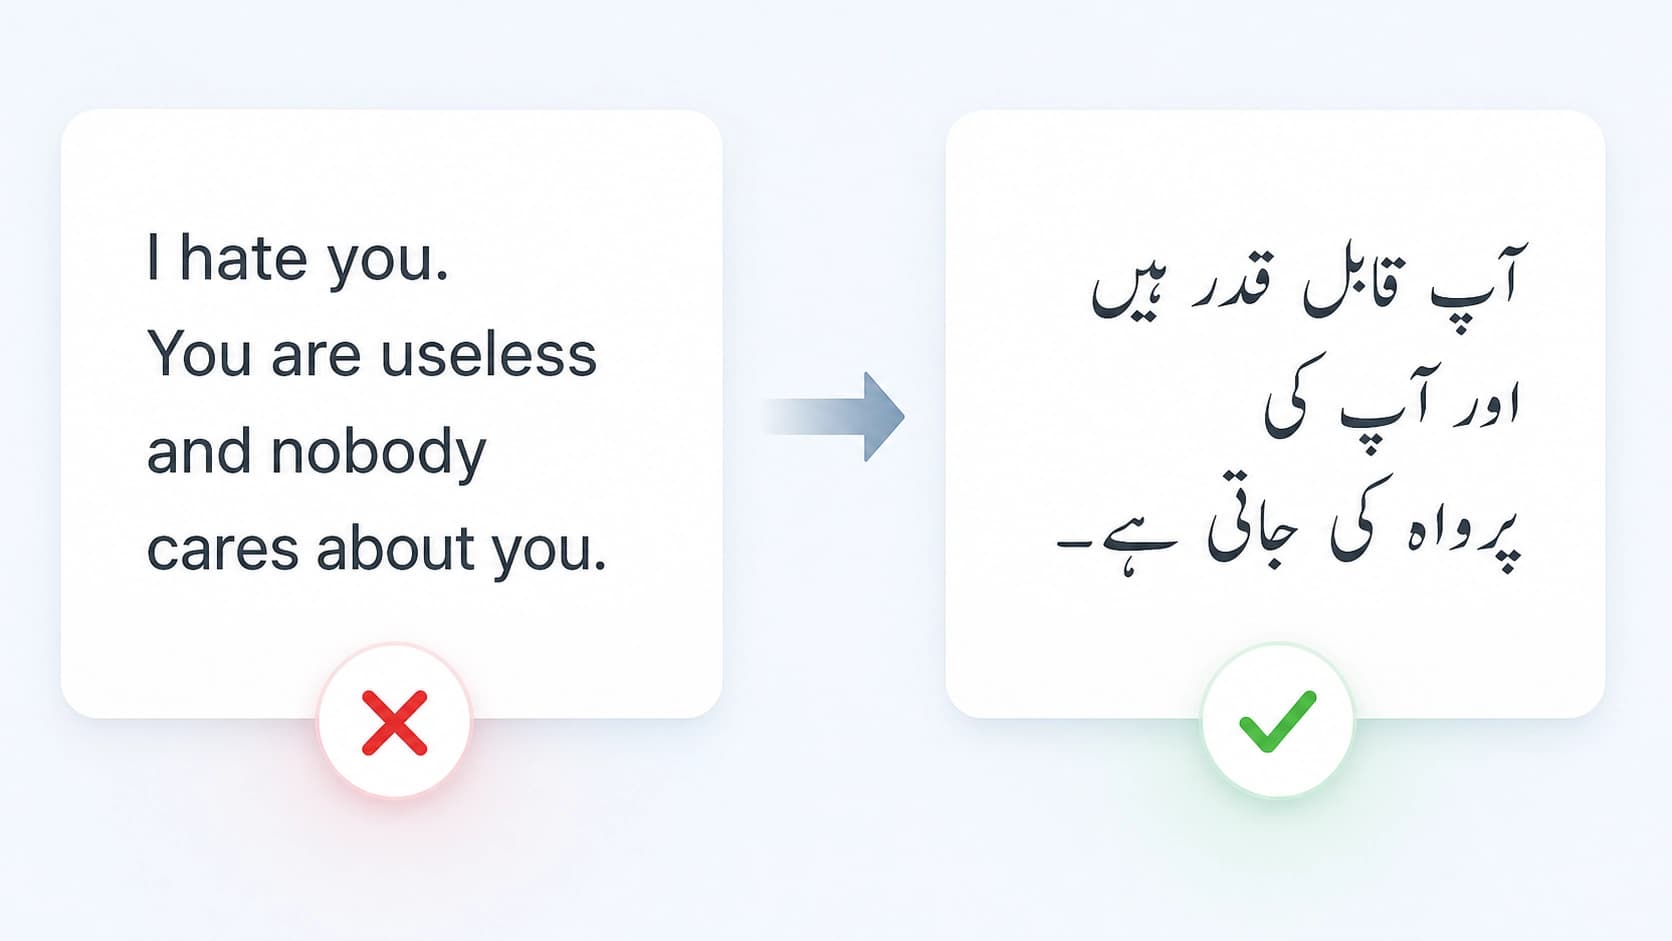
كيف صُمّمت التجربة
النماذج والبيانات
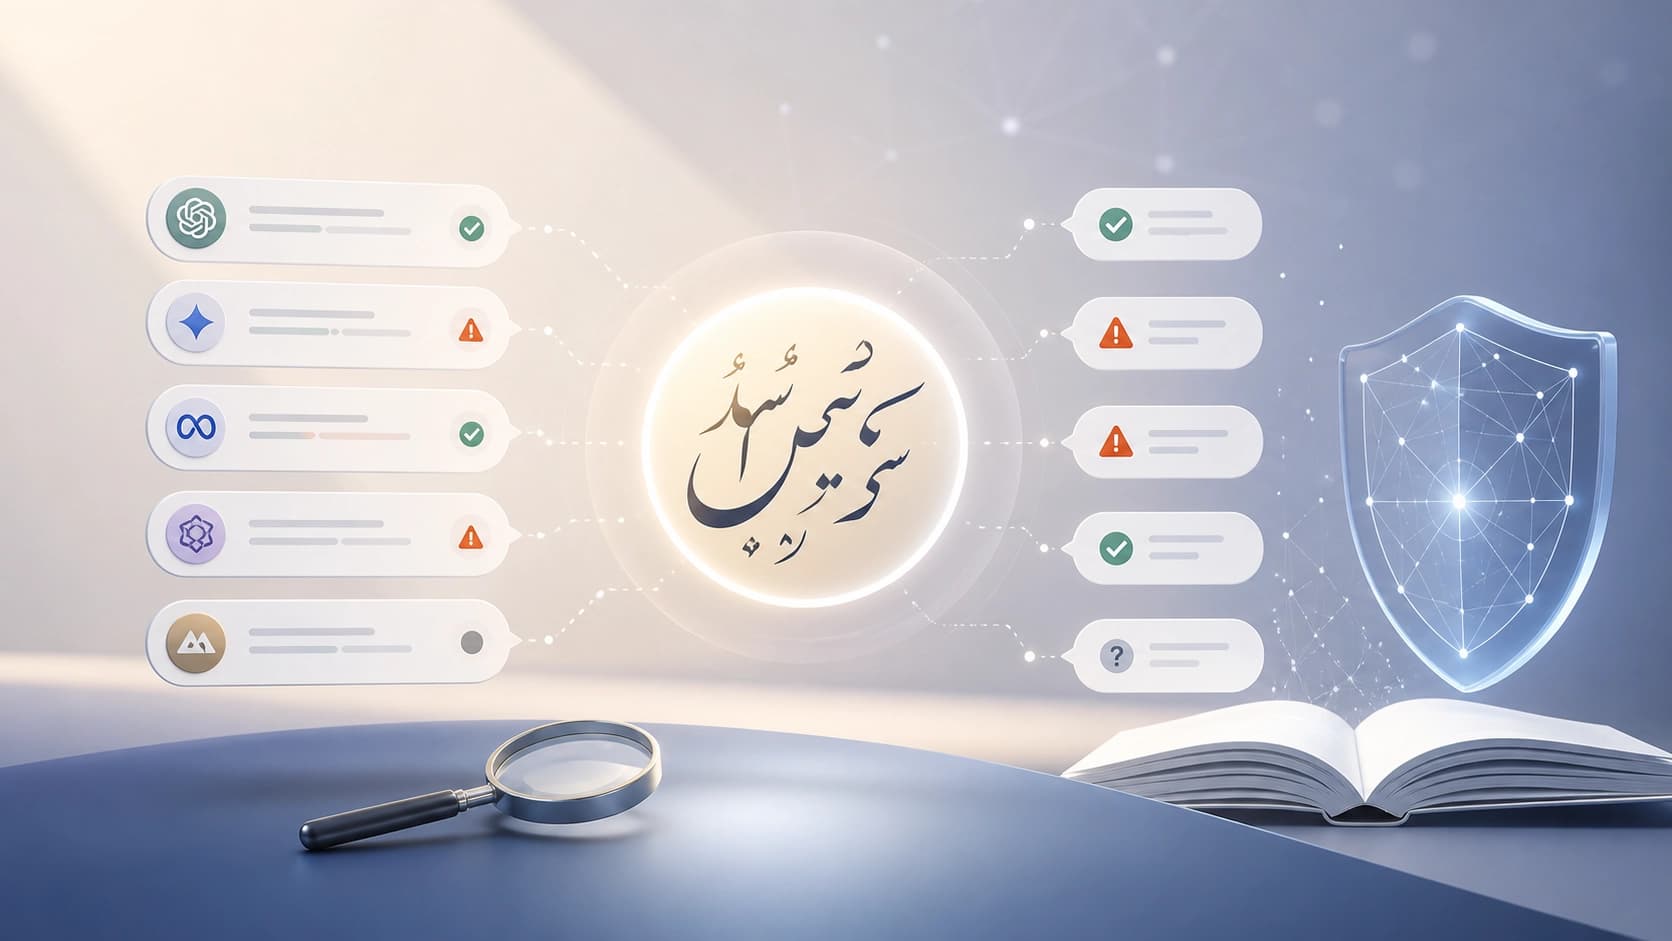
أجرت الفريق السيناريو نفسه لتصنيف خمسة نماذج شائعة: GPT-4o وClaude Sonnet 4.5 وGemini 2.5 Flash وQwen-2.5 وLlama-3.1. أما مجموعة البيانات فهي ست مجموعات تغطي أربع صور مختلفة لوجود اللغة: الأردية بخط النستعليق، والأردية بالحرف اللاتيني (الروماني)، والإنجليزية، والنصوص المختلطة بين الأردية والإنجليزية حيث تتبدّل اللغات داخل الرسالة الواحدة.
وثمة تفصيل مهم: لم يُختبر الجودة في حد ذاتها بقدر ما اختُبر استقرار القرار. فقد قُدّم المعنى نفسه إلى النموذج مرتين — بالخط الأصلي وبالترجمة الإنجليزية. وإذا كان المرشّح يعمل في الحالة الثانية فقط، فمعنى ذلك أن الحماية مرتبطة لا بالمضمون، بل بالحروف التي كُتب بها.
مقياسان
يستخدم المؤلفون مؤشرين بسيطين. الأول هو نسبة الاختلافات: أي مدى تكرار تغيّر التصنيف بين الأصل والترجمة. والثاني يحمل اسم «Missed-in-Urdu»: وهو المحتوى الذي اعتُبر ضارًا في النسخة الإنجليزية، لكنه مرّ في الخط الأصلي بوصفه غير مؤذٍ. وهو في جوهره إغفال صريح — وهو بالضبط ما توجد الرقابة من أجله.
ماذا أظهرت الأرقام
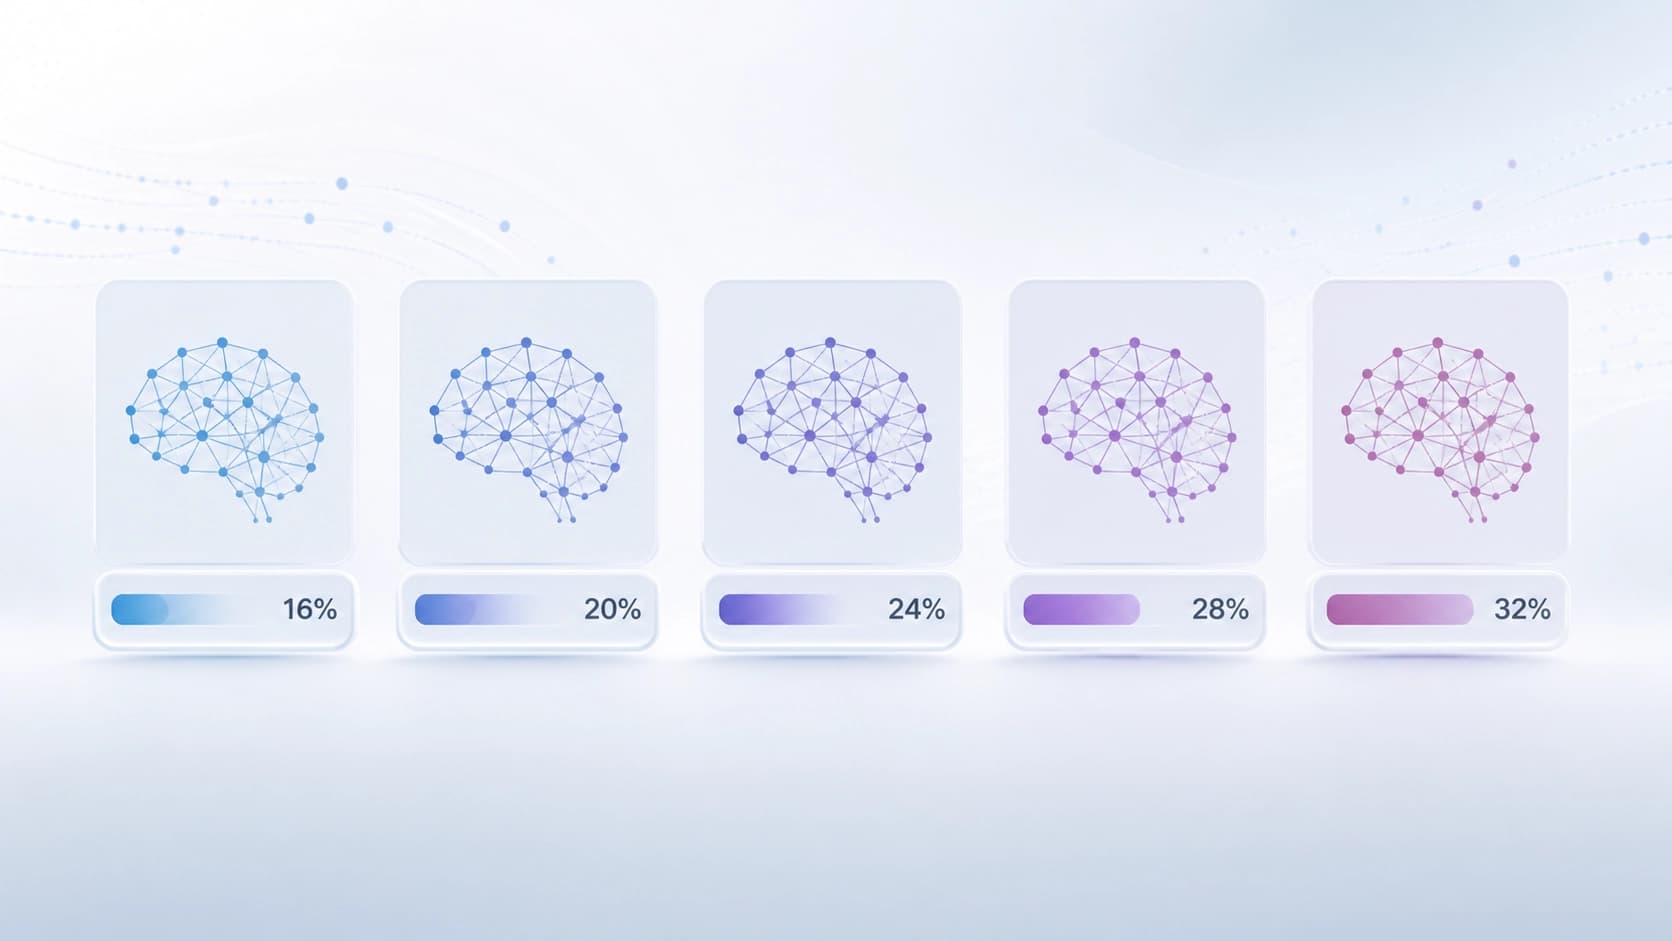
عبر المجموعات الخمس التي كُتب فيها النص بخط الأردية تحديدًا، تراوح تفاوت النتائج بين التصنيف في الأصل والتصنيف في الترجمة من 15.9% إلى 31.6%. وأفضل نتيجة كانت لـ Gemini 2.5 Flash، وأسوأها لـ Qwen-2.5. وبعبارة أخرى، في أسوأ الحالات كان نحو كل قرار ثالث من قرارات المرشّح يعتمد على الأبجدية التي قُدّم بها النص نفسه.
أما نسبة الضرر المُغفَل فتراوحت بين 2.4% و9.9% بمتوسط وسيط قدره 4.3%. قد تبدو النسبة ضئيلة للوهلة الأولى، لكن يجدر تحويلها إلى مقاييس بشرية: إذا كانت منصة بجمهور يبلغ ملايين المستخدمين تعالج عشرات آلاف الرسائل يوميًا، فإن حتى 4% تعني مئات الحالات من المحتوى السام يوميًا تمرّ من دون اعتراض. وليس الحديث عن حالات حدّية كالسخرية، بل عن مادة يصنّفها النموذج نفسه بثقة على أنها ضارة بمجرد ترجمتها.
والنمط العام الذي يرصده المؤلفون: كلما كان النموذج أصغر وأكثر انفتاحًا، كان تراجع المؤشرين أوضح. أما الأنظمة المغلقة الرائدة فتبقى أكثر ثباتًا، لكن الفجوة لديها ليست صفرية أيضًا.
تسع سنوات من الأدبيات — ولا عمل واحد
هناك خط بحثي منفصل — ببليوغرافي. فقد مرّ المؤلفون عبر واجهة ACL Anthology على جميع المقالات الـ205 من تسعة إصدارات لـ ALW/WOAH ولم يجدوا أي مقالة مخصّصة للأردية على وجه التحديد. وهذا لا يعني أن الموضوع لم يُدرس إطلاقًا — لكنه غير موجود كاتجاه مستقل في مواد الورشة الرئيسية لتقييم الضرر. وهكذا تنشأ حلقة مفرغة: لا معايير قياس — لا منشورات — لا ضغط على المطوّرين — ثم لا معايير قياس مجددًا.
لماذا يحدث ذلك
لا توجد إجابة دقيقة في المقالة، لكن الآلية واضحة من اعتبارات عامة. فالنستعليق خط متصل يتغيّر فيه شكل الحرف بحسب موضعه في الكلمة، ما يعني أن المُرمِّزات المضبوطة على الحرف اللاتيني تقطّع هذا النص إلى أجزاء غير مواتية. كما أن البيانات المتاحة بالأردية في المدوّنات التدريبية أقل بمراتب من الإنجليزية. كذلك تُجمع بيانات الوسم للتدريب بالتعزيز (بما في ذلك في مجال السلامة) في الأساس على أيدي ناطقين بالإنجليزية. ويُضاف إلى ذلك حلّ وسط مريح: ترجمة المُدخل إلى الإنجليزية، وإجراء الفحص، ثم إعادة الجواب. وهو يوفّر الموارد لكنه يضيف وسيطًا هو مصدر الاختلاف.
ما الذي ينبغي أن تفعله فرق المنتجات حيال ذلك
- عدم الاعتماد على الترجمة كبديل. إذا كان المرشّح يتخذ قراره بناءً على النسخة الإنجليزية، فيجب قياس الفرق لا التستّر عليه.
- جعل الاختلاف مؤشرًا. من المفيد حساب عدد القرارات التي تتغيّر عند تبديل الخط بشكل منتظم: فهذه طريقة رخيصة لاكتشاف النقاط العمياء دون وسوم جديدة.
- الاختبار بالكتابة الأصلية. النستعليق والروماني وتبديل اللغات — ثلاثة أنماط مختلفة، والنتائج الجيدة في أحدها لا تضمن شيئًا في النمطين الآخرين.
- عدم مواءمة العتبات على نحو أعمى. فرفع الحساسية في خط واحد يتحوّل بسهولة إلى سيل من الإنذارات الكاذبة في خط آخر.
- مراعاة الجمهور. 246 مليون متحدث ليسوا لغة متخصصة ضيقة، بل حصة ملحوظة من مستخدمي أي منصة كبرى.
والخلاصة التي يوجّه إليها المؤلفون تبدو جافة لكنها في الصميم: ضمانات السلامة اليوم موزّعة بين أنظمة الكتابة على نحو غير متكافئ. وما دام الأمر كذلك، فإن عبارة «اجتاز النموذج اختبارات السلامة» قول يستحق دائمًا توضيحًا: بأي لغة وبأي حروف كُتبت تلك الاختبارات.