
التحكم التنفيذي في وكلاء LLM: نقل تقييم التقدم وحق الإيقاف إلى خارج المولّد يوفّر ثلث الرموز
تصف الورقة البحثية الأولية نمطًا يواصل فيه وكيل لغوي إجراء تحسينات وفحوصات محدودة الفائدة بعد بلوغ الهدف، مبررًا ذلك بحلقة تعزز نفسها ذاتيًا، لا تنفصل فيها عملية التوليد عن تقييم التقدم واتخاذ قرار التوقف. وتحافظ طبقة التحكم الشامل المقترحة، التي تراعي عدم اليقين، على معدل نجاح يقارب 96.6%، مع خفض متوسط استهلاك الرموز بنسبة 36.4%، رغم أن النتائج مستخلصة حتى الآن من محاكاة ميكانيكية.
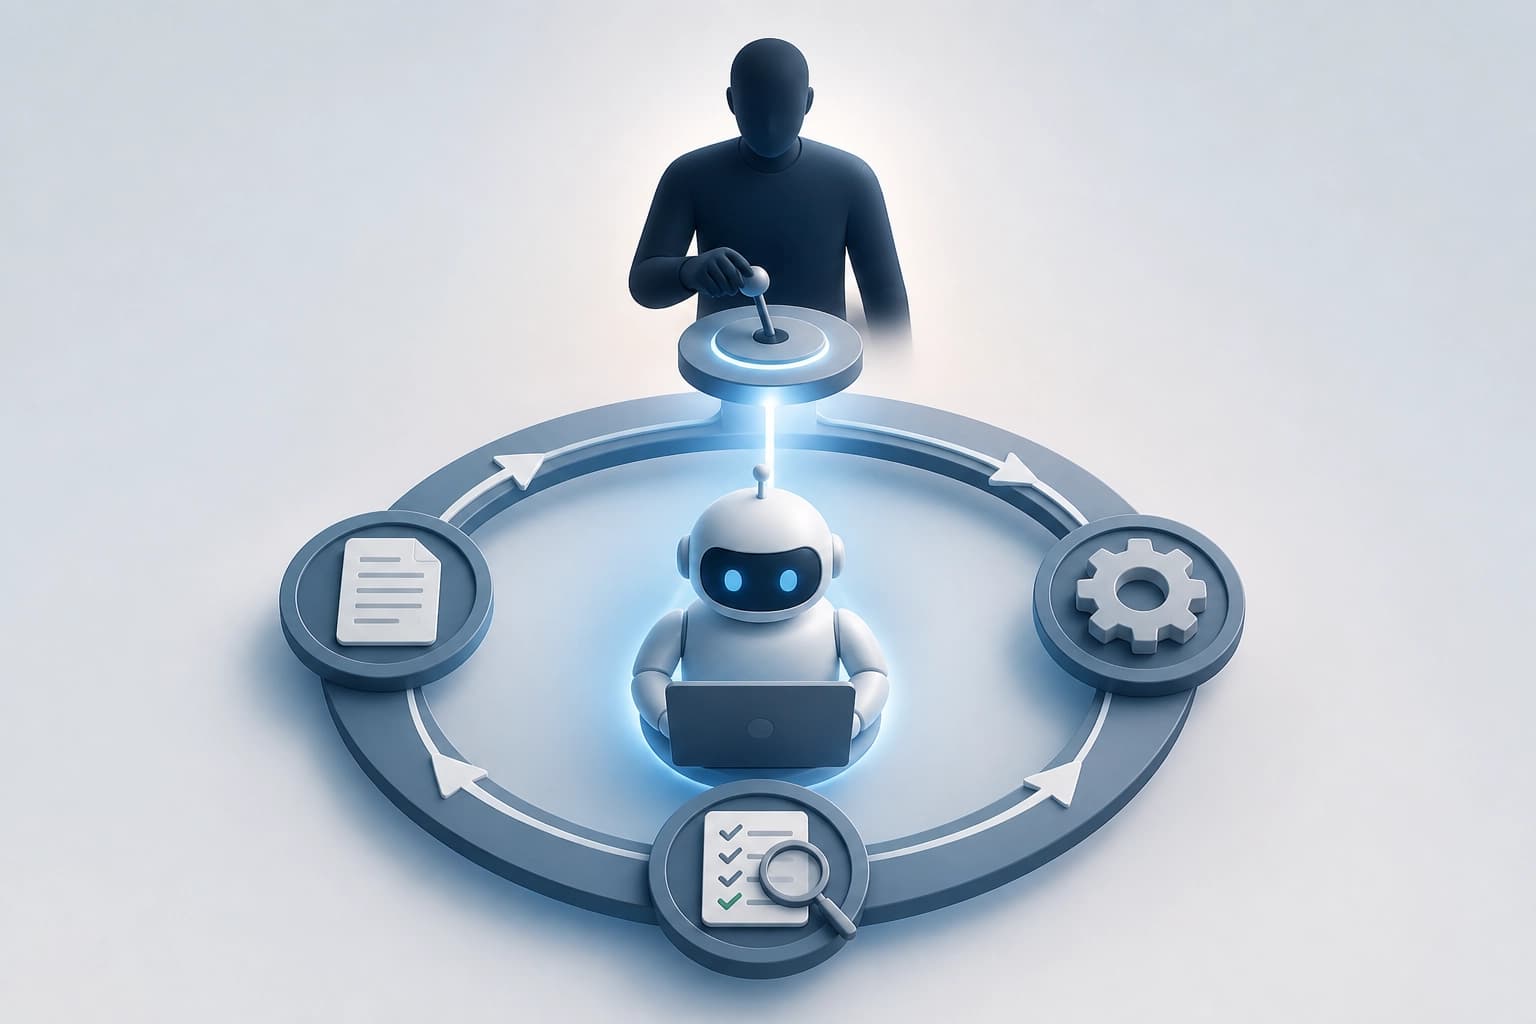
ما المقصود بـ LLM Parkinsonism
يُستخدم مصطلح LLM Parkinsonism بوصفه استعارة ضيقة غير سريرية. وهو يصف استمرار الأفعال على نحو متواصل رغم تراجع قيمتها بالنسبة إلى المهمة.
مؤشرات هذا السلوك:
- يواصل الوكيل العمل بعد تحقيق الهدف الأصلي؛
- ينفذ تحسينات منخفضة القيمة؛
- يجري عمليات تحقق متكررة؛
- يصلح التعقيدات التي تسبب فيها بنفسه.
الخلاصة: تشير الاستعارة إلى خلل في التحكم، لا إلى تشبيه سريري.
لماذا يؤدي التحكم الذاتي في حلقة واحدة إلى تفاقم المشكلة
يربط المؤلفون المشكلة بأكثر من مجرد التنبؤ التتابعي بالرمز التالي. فالسبب يكمن أيضًا في تركيز أربع وظائف ضمن حلقة واحدة.
- توليد المقترحات؛
- تفسير نطاق المهمة؛
- تقييم التقدم؛
- صلاحية الإيقاف.
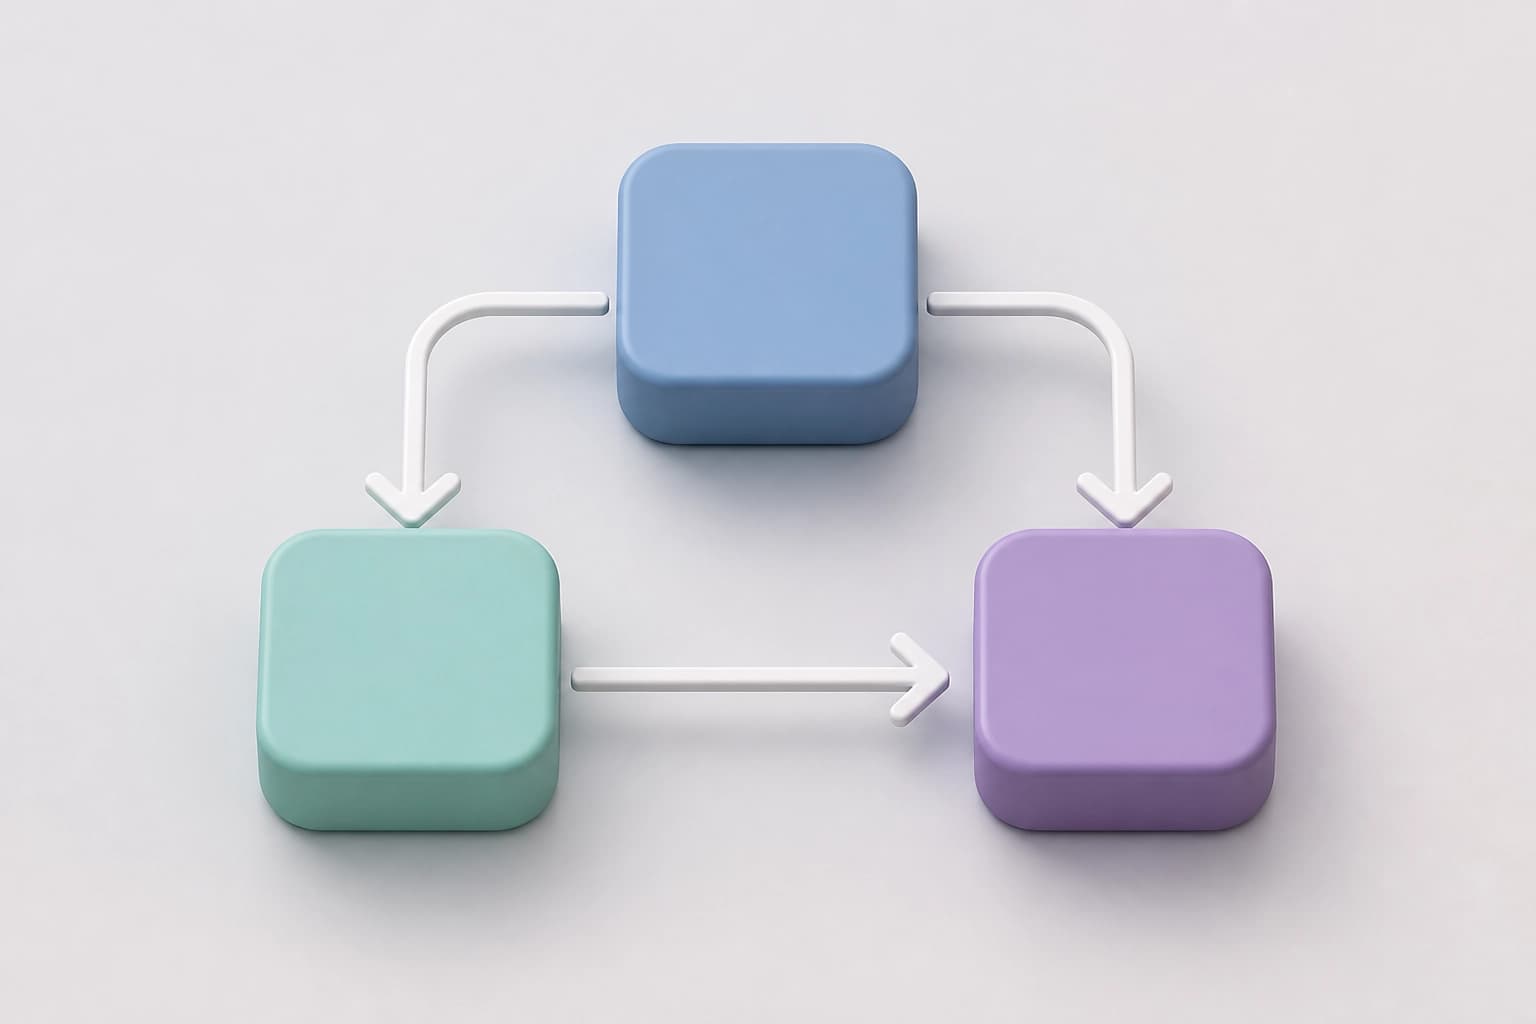
تعمل هذه الحلقة بتعزيز ذاتي. إذ يؤثر التقييم والتوليد والإيقاف بعضها في بعض.
الخلاصة: لكسر التعزيز الذاتي، ينبغي إخراج بعض الوظائف من نطاق المولّد.
Global Executive Control: ما الذي يُنقل خارج نطاق المولّد
Global Executive Control (GEC) v0.2 هو بنية للتحكم تراعي عدم اليقين. وهي تفصل بين توليد الأفعال والتحكم على مستوى المشروع.
ما يُنقل خارج نطاق المولّد:
- نطاق المهمة؛
- الأدلة؛
- استهلاك الموارد؛
- الإيقاف.
يحصل التحكم على مستوى المشروع على صلاحية الإيقاف وتقييم التقدم. أما المولّد فيتولى الأفعال.
الخلاصة: المعيار العملي هو أن يكون تقييم التقدم والإيقاف خارج حلقة التوليد.
ما الذي تُظهره القياسات
شمل الاختبار المعياري 24,000 حلقة مع مرشحين قابلين للمقارنة وحدّ إجمالي قدره 40,000 رمز. وقورنت ثلاثة خيارات.
| خيار التحكم | النجاح وفق الهدف الصارم |
|---|---|
| خط أساس مع المرشح الأول | 67.42% |
| تحكم محلي مع مجموعة من المرشحين | 96.53% |
| GEC | 96.57% |
يفسر الوصول إلى خيارات متعددة للأفعال معظم الزيادة في النجاح. حافظت GEC على معدل النجاح وخفّضت متوسط استخدام الرموز.
- متوسط استخدام الرموز: من 19,782 إلى 12,574 (36.4%)؛
- متوسط عدد الرموز المقيّد حتى الإكمال، ضمن حد أقصى قدره 40,000 رمز: من 16,136 إلى 13,114 (18.7%).
قضت GEC على الانحراف المقاس قبل إكمال المهمة، وخفّضت التعقيدات الزائدة بدرجة كبيرة. وظلت حساسية العبء الإضافي للتحكم مواتية عند إضافة ما يصل إلى 500 رمز تحكم اصطناعي في كل دورة.
الخلاصة: تحقق مجموعة المرشحين الزيادة الأساسية في النجاح؛ وتضيف GEC إلى ذلك توفيرًا في الرموز وتحكمًا في التعقيد.
معايير عملية لاختيار نظام التحكم
يجدر التحقق من خمسة شروط:
- فصل التقييم الخارجي للتقدم عن المولّد؛
- وجود صلاحية الإيقاف خارج حلقة التوليد؛
- إتاحة عدة خيارات للأفعال؛
- مراعاة استهلاك الموارد؛
- مراعاة عدم اليقين.
الخلاصة: إذا ظلت هذه الوظائف داخل المولّد، فستبقى مخاطر التحسينات منخفضة القيمة واستهلاك الرموز الزائدة قائمة.
القيود وما ينبغي التحقق منه لاحقًا
أُجريت النتائج باستخدام محاكاة آلية. ويرى المؤلفون أنها تدعم التحكم الصريح في نطاق المهمة والأدلة واستهلاك الموارد والإيقاف.
القيود:
- لا بد من إجراء اختبارات على نماذج حقيقية؛
- لا تُغني المحاكاة الآلية عن هذه الاختبارات.
الخلاصة: يبدو المبدأ المعماري مدعومًا، لكن لا يجوز تعميم الأرقام على نماذج LLM الحقيقية دون التحقق منها.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
اختبار وكلاء البرمجة في تطوير XR التفاعلي: نتائج GenXR-Bench
نُشرت GenXR-Bench، وهي مجموعة تضم 112 مهمة من إعداد خبراء لتقييم وكلاء البرمجة تقييمًا شاملًا في تطوير XR التفاعلي، بدءًا من تحسين الوظائف وإصلاح العيوب وصولًا إلى إنشاء التطبيقات والتحقق من سلوكها على أجهزة استهلاكية. حقق أفضل أداء بين النماذج العشرة التي خضعت للاختبار 50.9% Pass@1؛ وشملت الإخفاقات المتكررة التعامل مع الأحداث غير المتزامنة للمستشعرات، وربط الكائنات بالفضاء الواقعي، وفهم التفاعل في السياق المادي.
5 نوفمبر 2026
من المكافأة القياسية إلى جبهة باريتو: توليف RTL باستخدام النماذج اللغوية الكبيرة والتعلّم المعزّز متعدد المعايير
اقتُرحت طريقة لتدريب نموذج لغوي على توليد مجموعة من مرشّحات RTL بدلًا من مخطط واحد، مع مفاضلات مختلفة بين المساحة وزمن التأخير واستهلاك الطاقة؛ وتُبنى المكافأة على مساهمة كل خيار في حجم فرط جبهة باريتو. على RTLLM v2، ارتفع حجم فرط باريتو النسبي بمقدار 13.3 نقطة مئوية مقارنةً بالإصدار الأساسي من دون تحسين PPA، وبمقدار 14.4 نقطة مئوية مقارنةً بالتدريب بالتعلّم المعزّز ذي الهدف الواحد.
5 نوفمبر 2026
تتعرّف النماذج اللغوية الكبيرة الطبية على تحديثات التوصيات، لكنها غالبًا ما تجيب وفقًا للإرشادات القديمة
أظهرت دراسة ChronoEvo التي شملت 1709 تغييرات في التوصيات السريرية أن النموذج الأساسي رصد التحديث في 90,8% من الإجابات، لكنه طبّقه بالكامل في 58,5% فقط، وظلت فجوة قدرها 32,3 نقطة مئوية قائمة لدى 14 نموذجًا. وحتى تعزيز بروز التحديثات لم يحقق زيادة ملحوظة في التطبيق الكامل للقواعد الجديدة ضمن التوصيات السريرية.
4 نوفمبر 2026