جوهر HyCO
HyCO — Hybrid Neural Solver for Combinatorial Optimization. تبني الطريقة بادئة الحل باستخدام محلّل RL. ثم تنتقل تكيفيًا إلى نموذج انتشار شرطي. وهو يكمل الحلول المتبقية. يحل هذا المزيج مسائل التحسين التوافقي العصبي. ومهمته الجمع بين نقاط القوة لدى فئتين من المحلّلات.
العمل متاح على arXiv:2609.07990. المؤلفون: Yuheng Li, Di Yang, Haipeng Chen, Yanhai Xiong. تنتمي المسودة الأولية إلى cs.LG وcs.AI. وقد قدّم المؤلفون النسخة v1 في 7 Sep 2026. تساعد هذه البيانات في العثور على المصدر الأصلي والتحقق من التفاصيل.
المعنى العملي: HyCO لا يستبدل محلّلًا بآخر، بل يدير الانتقال بينهما.
أين تنكسر الاستراتيجيات المنفردة
تُظهر محلّلات RL التتابعية ومحلّلات DM الشاملة أنماط فشل متكاملة. ويظهر ذلك في regret التحسين.
| فئة المحلّل | نقطة القوة | نقطة الضعف |
|---|---|---|
| Sequential RL | regret هامشي صغير في المرحلة المبكرة من البناء | تتراكم الأخطاء على مدى الأفق؛ وينمو regret فوق خطيًا |
| Global DM | يتجنب التراكم على مدى الأفق | regret خطي أو تحت خطي بالنسبة لأبعاد الفضاء الفرعي المتبقي غير المحلول |
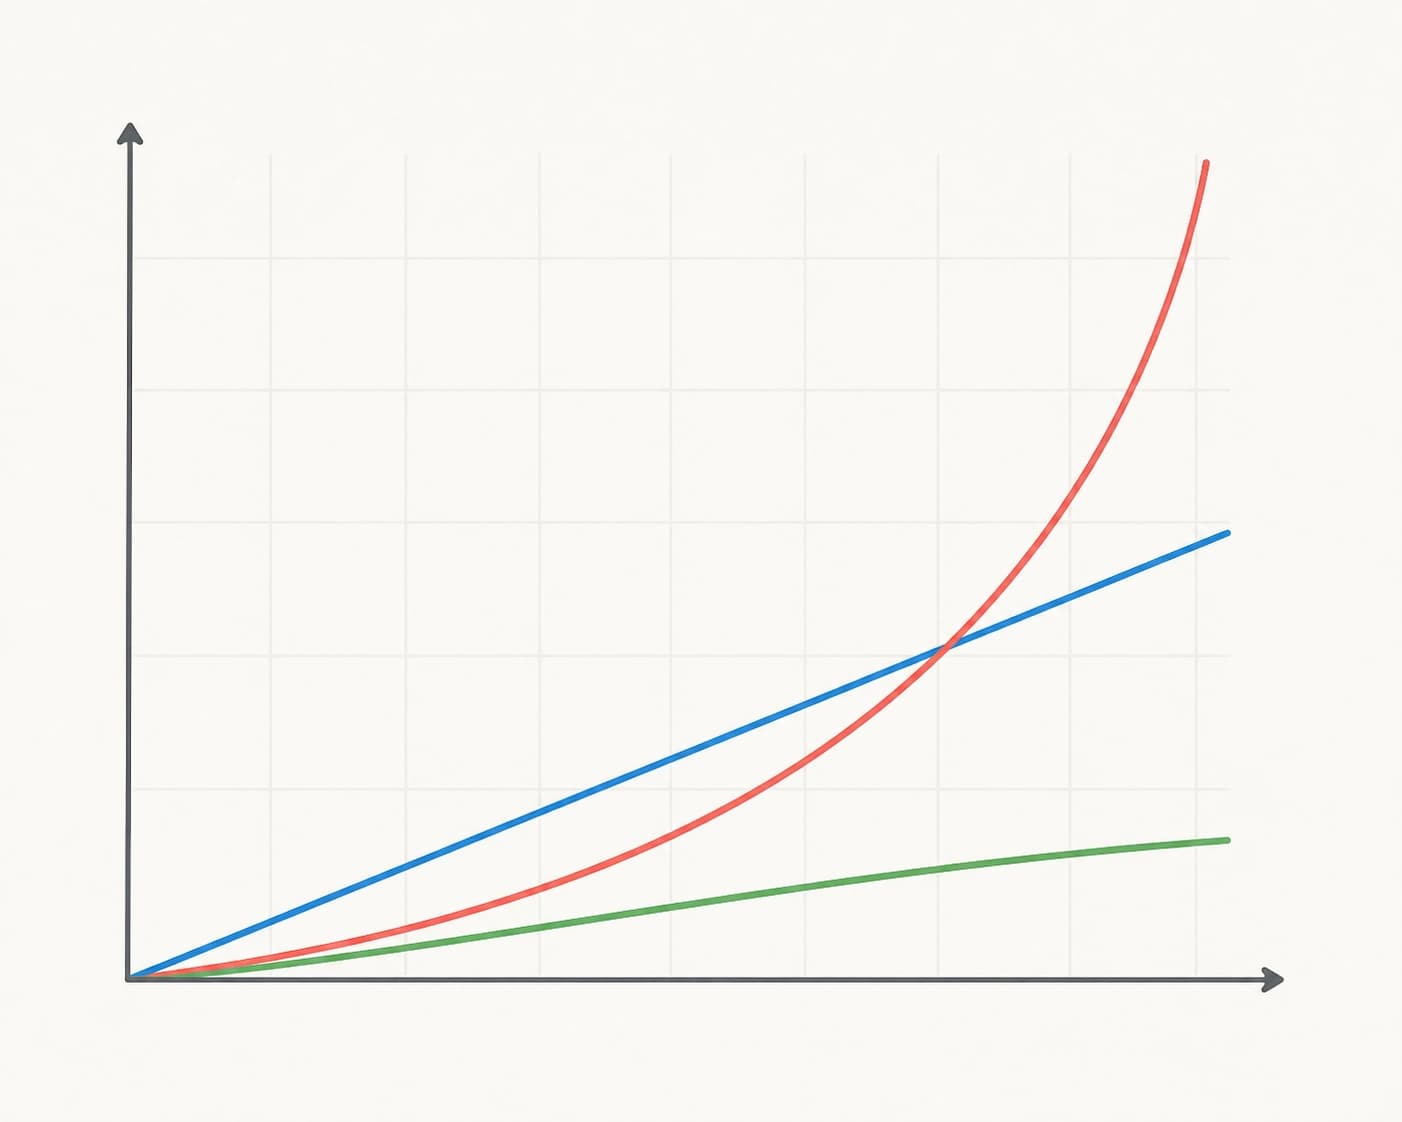
الخلاصة: الإخفاقات لا تتطابق. RL جيد في البداية، لكنه يعاني من الأفق. وDM لا يراكم خطأ الأفق، لكنه يدفع ثمن حجم المسألة المتبقية. ويستفيد التهجين من هذه الفجوة.
الإطار النظري للتبديل
يبني المؤلفون إطارًا نظريًا موحّدًا لتوسّع الأخطاء. وفي ظل افتراضات صريحة حول توسّع الأخطاء، يثبت الإطار موضعين.
- البنية الهجينة تعطي regret متوقعًا أصغر تمامًا من كل من المخططين الأساسيين على حدة.
- توجد خطوة تبديل مثالية وحيدة تُصغّر regret المزيج.
يحدد المؤلفون الخطوة المثالية على مستوى regret المتوقع. وعلى المسارات الفردية لا يمكن حسابها مباشرة. لذلك يلزم محفّز عملي.
الخلاصة: تجيب النظرية عن سبب جدوى المزيج ومتى يُطلق التسليم. لكنها لا تقدّم صيغة جاهزة لكل مسار.
كيف يعمل المحفّز التكيفي
يستخدم HyCO محفّزًا تكيفيًا خفيفًا. يجمع المحفّز بين إنتروبيا السياسة وتباعد RL-DM. وتكشف هذه الإشارات تغيّر النمط على مستوى المسار. وهي تعمل كبديل عملي. ويلزم هذا البديل لأن الخطوة المثالية للتبديل لا تُحسب على مسار فردي.
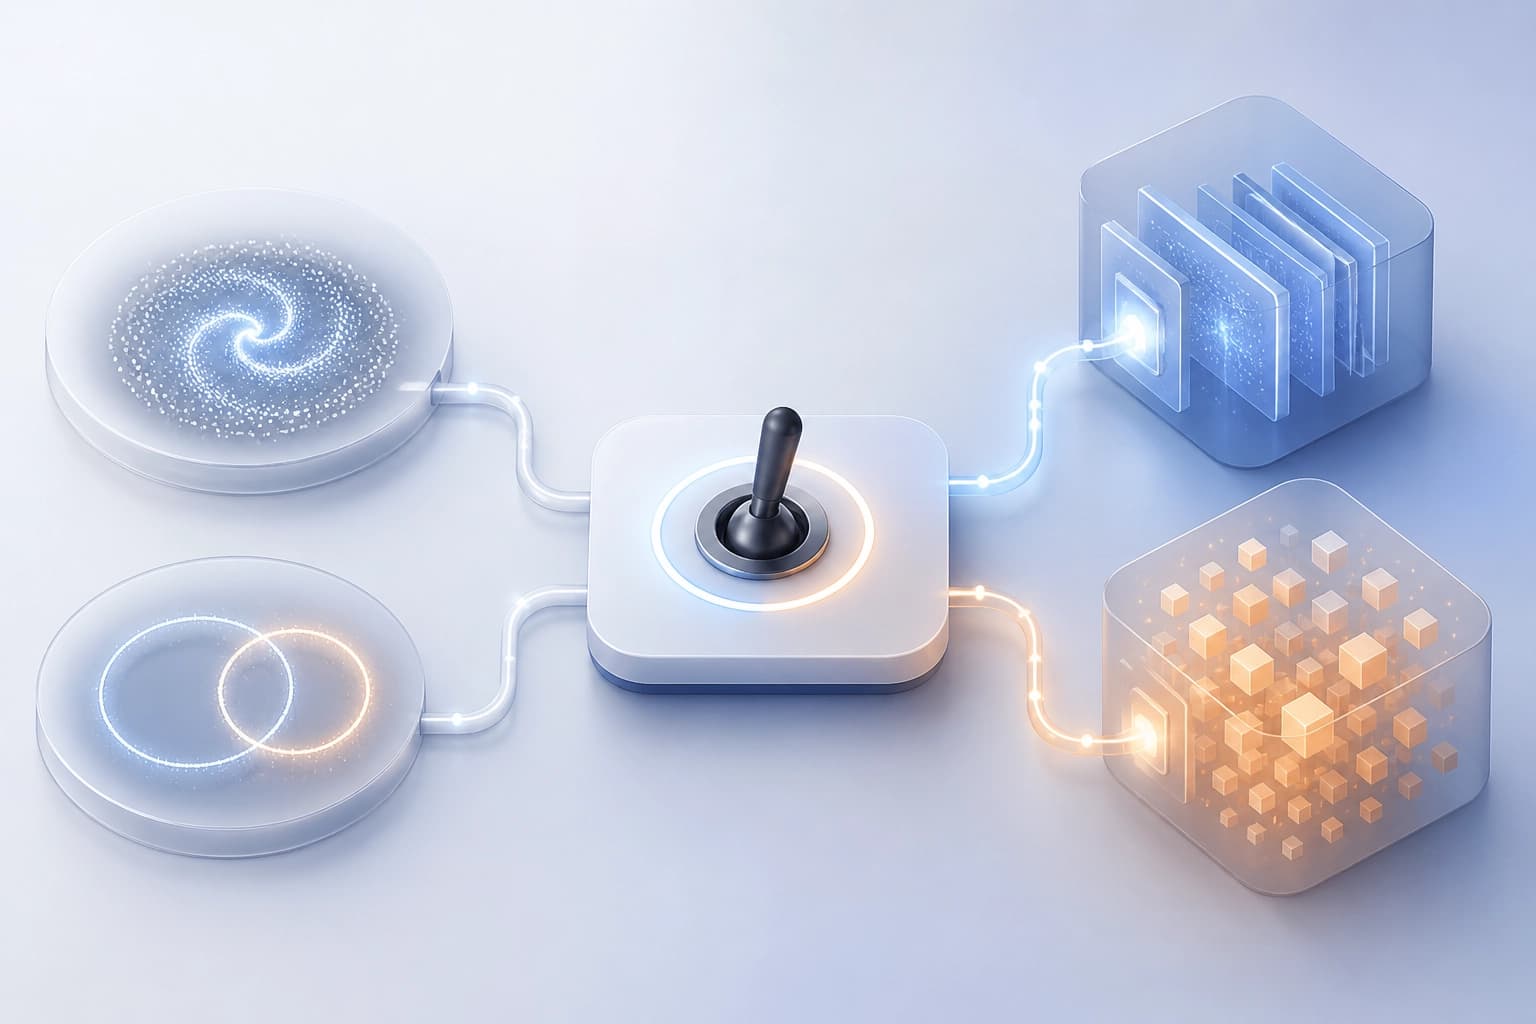
يُنهي المحفّز بادئة RL. ويكمل الانتشار الشرطي DM الحلول المتبقية. المعيار العملي: مراقبة إنتروبيا السياسة وتباعد RL-DM. وتشير هذه الإشارات إلى تغيّر النمط ولحظة التسليم. ويبقى المحفّز خفيفًا وتكيفيًا.
التجارب ومعيار الاختيار
في التجارب على معايير متنوعة، يعطي HyCO تحسينات مستقرة مقارنةً بكلا المحلّلين الأساسيين. وتؤكد النتائج أيضًا الفعالية التجريبية للمحفّز التكيفي.
المعيار العملي للاختيار: يلزم خوارزمية استدلال للتحسين التوافقي. وهي تستخدم RL للبادئة المبكرة وDM للحلول المتبقية. ويقلّل المزيج regret المتوقع مقارنةً بكل مخطط أساسي. ويناسب HyCO كطبقة تبديل فوق بحث RL والإكمال بالانتشار. وهو يدير الانتقال بينهما.