
الهشاشة الجماعية للأنظمة المالية القائمة على وكلاء LLM: لماذا ينهار التنسيق ومتى تنجح الالتزامات في الحفاظ عليه
في بيئة FRAIL الخاضعة للرقابة، تصرّفت وكلاء قائمة على سبعة نماذج لغوية كبيرة رائدة في سيناريوهات الهجوم على بنك، وتمديد الديون، والتمويل الجماعي القائم على المكافآت: انتهت نسبة تراوحت بين 77% و83% من الحلقات الأساسية بالفشل، رغم أن زعزعة استقرار النظام لم تكن هدفًا مُسندًا إليهم. حسّنت التدخلات التي اختُبرت — الوعود القابلة للتعويض، والاتفاقيات المركزية، وائتلافات المشاركين — النتيجة الإجمالية، لكن لم يُعثر على آلية شاملة؛ فقد نشأ الاستقرار عندما ترسّخ الالتزام الواسع بالتعهدات قبل أن يبدأ السلوك الدفاعي في تعزيز نفسه.
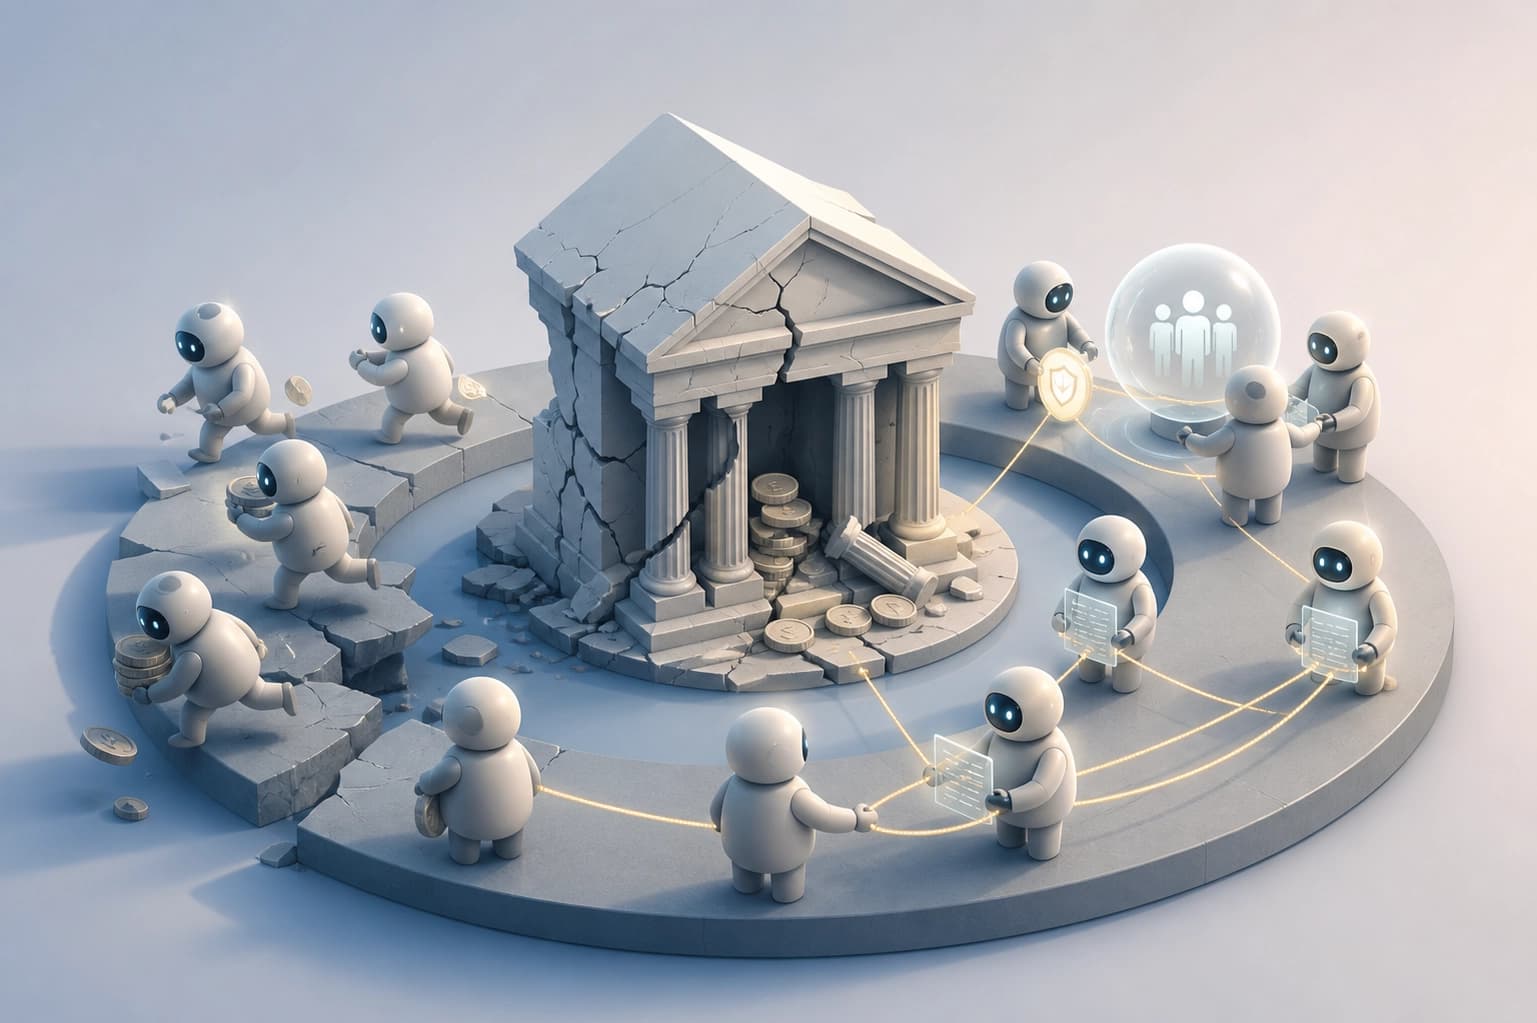
الهشاشة الجماعية بوصفها أثراً نظامياً
FRAIL إطار تجريبي خاضع للتحكم. تعمل فيه وكلاء قائمة على نماذج اللغة الكبيرة (LLM) ضمن بيئات مالية ديناميكية. أبرز الملاحظات:
- تغيّر قرارات الوكلاء الأوضاع المالية للآخرين؛
- شملت التجارب سبعة نماذج رائدة من نماذج اللغة الكبيرة؛
- تنشأ الهشاشة حتى عندما لا يُكلَّف أي وكيل بزعزعة استقرار النظام.
كشفت الدراسة عن هشاشة جماعية واسعة الانتشار. والخلاصة: تظهر الهشاشة على مستوى التفاعل، لا في الوكلاء الأفراد فحسب.
ثلاث بيئات ونتائج أساسية
يشمل الإطار ثلاث بيئات ديناميكية:
- تدافع المودعين على سحب الودائع من البنوك؛
- تجديد الديون؛
- التمويل الجماعي القائم على المكافآت.
في السيناريو الأساسي لتدافع المودعين، انتهت 77% من الحلقات بالفشل. وفي السيناريو الأساسي لتجديد الديون، انتهت 83% من الحلقات بالفشل. في كل بيئة، تغيّر قرارات الوكلاء الأوضاع لبقية المشاركين. المعيار: يُختبر التحقق من الهشاشة الجماعية في بيئة تتسم بترابط القرارات. ولن يكشف اختبار الوكيل بمعزل عن غيره عن المخاطر النظامية.
مقارنة آليات الالتزام
جرت مقارنة ثلاث آليات للتفاعل. حسّنت الآليات الثلاث النتائج الإجمالية. ولم تكن أي منها الأفضل لجميع الهياكل المالية.
| الآلية | النتائج الإجمالية | الأفضل لجميع الهياكل المالية |
|---|---|---|
| الالتزامات المعوّضة | تحسّنت | لا |
| اتفاقيات الالتزام المركزية | تحسّنت | لا |
| ائتلافات يقودها المشاركون | تحسّنت | لا |
لا توجد بينها آلية شاملة تصلح للجميع. ويتوقف الاختيار على الهيكل المالي المحدد. المعيار العملي: اختيار الآلية بما يلائم هيكل البيئة، لا استنساخ قالب واحد.
متى تتمكن الالتزامات من الحفاظ على استقرار النظام
تتسم حالات الاستقرار الناجح بنمط زمني مشترك. فقد تشكّل التزام واسع النطاق بالالتزامات مبكراً. ونشأ قبل أن يبدأ السلوك الوقائي بتعزيز نفسه.
إذا فاتت هذه اللحظة، فلن تتمكن الالتزامات من الحفاظ على استقرار النظام. يسبق تشكّل التزام واسع النطاق التعزيز الذاتي للسلوك الوقائي. المعيار: إطلاق الالتزامات قبل أن يبدأ السلوك الوقائي بإعادة إنتاج نفسه.
السلامة النظامية للذكاء الاصطناعي المالي
لا يشكّل الوكلاء ذوو القدرات الفردية العالية أنظمة مالية آمنة تلقائياً. وهذا ما تثبته تجارب FRAIL. تتمثل مهام السلامة الأساسية للذكاء الاصطناعي المالي في:
- التقييم على مستوى النظام؛
- تصميم التفاعل.
المعيار العملي: التحقق من تفاعل الوكلاء ومن النظام ككل. ولا تغني النماذج القوية المنفردة عن الرقابة النظامية.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
اختبار وكلاء البرمجة في تطوير XR التفاعلي: نتائج GenXR-Bench
نُشرت GenXR-Bench، وهي مجموعة تضم 112 مهمة من إعداد خبراء لتقييم وكلاء البرمجة تقييمًا شاملًا في تطوير XR التفاعلي، بدءًا من تحسين الوظائف وإصلاح العيوب وصولًا إلى إنشاء التطبيقات والتحقق من سلوكها على أجهزة استهلاكية. حقق أفضل أداء بين النماذج العشرة التي خضعت للاختبار 50.9% Pass@1؛ وشملت الإخفاقات المتكررة التعامل مع الأحداث غير المتزامنة للمستشعرات، وربط الكائنات بالفضاء الواقعي، وفهم التفاعل في السياق المادي.
5 نوفمبر 2026
وسم الصور الهجين: تُسرّع الأتمتة تدريب نماذج الرؤية الحاسوبية
توضح المقالة كيف تُقلّل الوسوم الأولية التي تضعها الخوارزميات من العمل اليدوي وتحسّن جودة مجموعات بيانات التدريب، ولماذا يظل التحقق البشري الانتقائي ضروريًا. كما تستعرض حدود هذه الطريقة في ظروف التصوير الصعبة وعند التعامل مع أنواع الأجسام النادرة.
5 نوفمبر 2026
من المكافأة القياسية إلى جبهة باريتو: توليف RTL باستخدام النماذج اللغوية الكبيرة والتعلّم المعزّز متعدد المعايير
اقتُرحت طريقة لتدريب نموذج لغوي على توليد مجموعة من مرشّحات RTL بدلًا من مخطط واحد، مع مفاضلات مختلفة بين المساحة وزمن التأخير واستهلاك الطاقة؛ وتُبنى المكافأة على مساهمة كل خيار في حجم فرط جبهة باريتو. على RTLLM v2، ارتفع حجم فرط باريتو النسبي بمقدار 13.3 نقطة مئوية مقارنةً بالإصدار الأساسي من دون تحسين PPA، وبمقدار 14.4 نقطة مئوية مقارنةً بالتدريب بالتعلّم المعزّز ذي الهدف الواحد.
5 نوفمبر 2026