
منهج CHOIR: يكشف التعداد الحر عن المواقف المتباينة للنماذج داخل الأنظمة الجماعية
يقترح المؤلفون نهج CHOIR، حيث تطلب مجموعات النماذج مرارًا قوائم إجابات مرتبة، ثم تقارن بروز المفاهيم الموحّدة بين النماذج وصياغات المطالبات وظروف الأدوار. ويُظهر البحث أن التشابه الظاهري الكبير بين الإجابات المفتوحة لا يعني بالضرورة توافقًا في الرأي: إذ تظل هوية النموذج الأساسي أكثر السمات تمييزًا وثباتًا، بينما تُغيّر إعدادات الشخصيات المفاهيم التي يُعبّر عنها.
ما الذي يقدّمه CHOIR
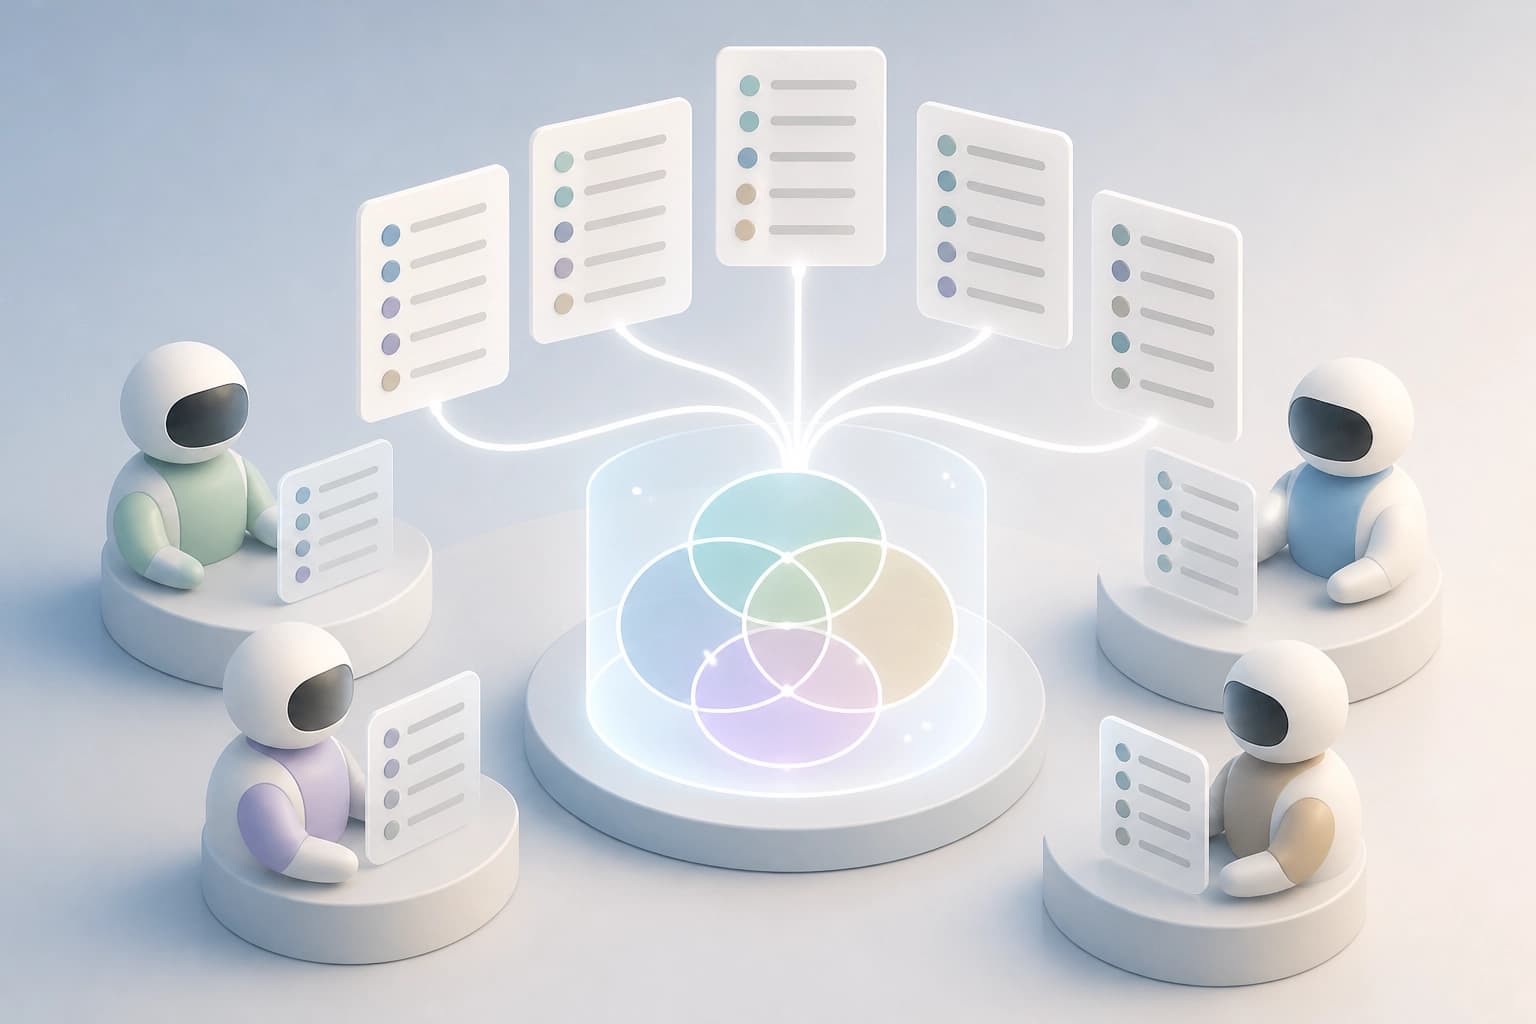
CHOIR هو اختصار لـ Collective Hierarchically-Ordered Inquiry Responses. يكيّف هذا النهج أسلوب الاستثارة بالقوائم الحرة ليتناسب مع مجموعات نماذج LLM. وتتمثل مهمته في كشف المواضع التي تختلف فيها النماذج داخل المجموعة. فالتوافق الظاهري بين الإجابات يخفي هذه الاختلافات.
تعمل الطريقة مع القوائم، لا مع الصياغات الجاهزة. وتوفّر الاستعلامات المتكررة مادةً توضّح الموضوعات التي تطرحها النماذج من تلقاء نفسها. ثم تُحوَّل هذه المادة إلى صيغة تتيح المقارنة.
معيار عملي: استخدم CHOIR عندما تبدو إجابات المجموعة متطابقة، وتحتاج إلى معرفة مواضع اختلاف النماذج تحديدًا.
مراحل عمل الطريقة
تتألف الطريقة من ثلاث خطوات.
- إرسال استعلامات متكررة إلى نماذج المجموعة للحصول على قوائم مرتبة.
- دمج عناصر القوائم في مفاهيم على مستوى الموجّه.
- قياس بروز المفاهيم بين النماذج، وإصدارات الموجّهات، والظروف التي تتضمن شخصيات.
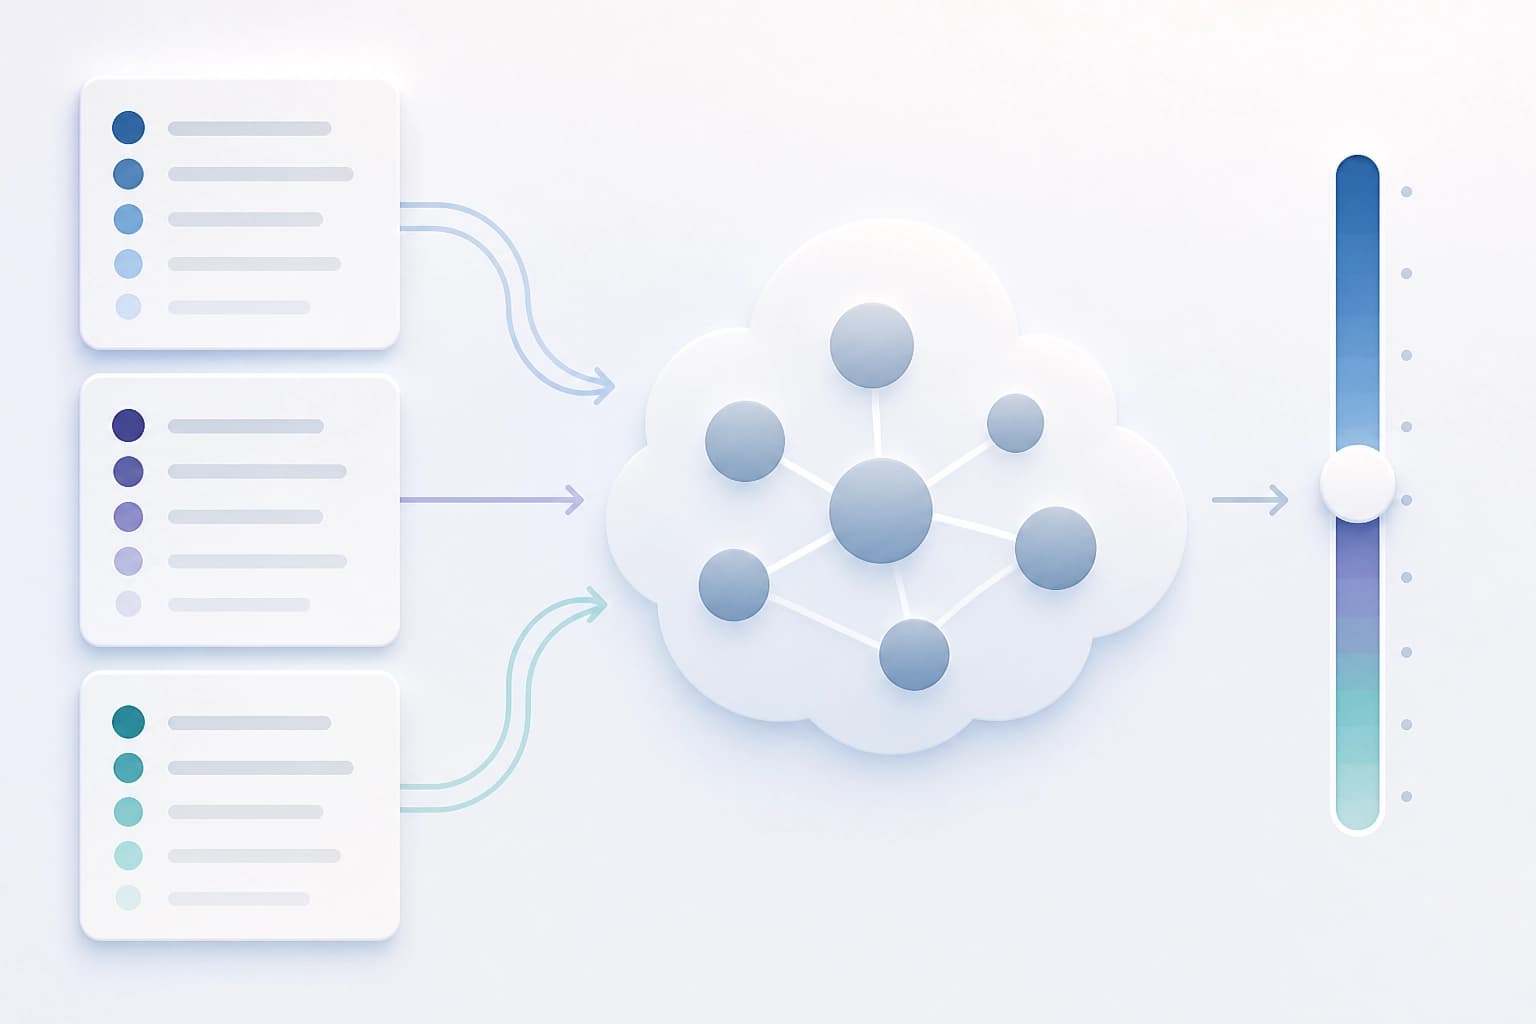
تضيف كل خطوة بُعدًا جديدًا. توفّر القوائم المادة الخام، ويحوّلها الدمج إلى صيغة قابلة للمقارنة، فيما يكشف قياس البروز عن الاختلافات. ومن دون تحويل العناصر إلى مفاهيم، تظل المقارنة على مستوى الكلمات المفردة.
معيار عملي: اختبر الطريقة للتحقق مما إذا كانت تحافظ على الاختلافات بعد دمج العناصر في مفاهيم.
المجموعات التي اختُبرت عليها
| المجموعة | ما هي | ما الذي أظهرته |
|---|---|---|
| Infinity-Chat 100 | مجموعة خارجية من الموجّهات، مأخوذة من دراسة حديثة عن تجانس الإجابات المفتوحة للنماذج | تؤكد وجود توافق ظاهري مرتفع: 93/100 من الموجّهات تتجاوز مستوى الصدفة. كما تميّز بين الموجّهات الضيقة والواسعة، التي تكشف عن عمق خفي في الإجابات |
| مجموعة تشخيصية مستهدفة | 27 سؤالًا لكشف الاختلافات على مستوى الآليات | تُستخدم لإجراء فحوص مستهدفة للاختلافات بين النماذج |
تؤدي المجموعتان مهمتين مختلفتين. تعرض المجموعة الخارجية الصورة العامة للتوافق، وتفصل في الوقت نفسه بين الموجّهات الواسعة والضيقة. أما المجموعة المستهدفة فهي مصممة للكشف عن الاختلافات على مستوى الآليات.
معيار الاختيار: استخدم مجموعة الموجّهات الخارجية لتكوين صورة عن التوافق، والمجموعة التشخيصية لتحليل الآليات.
ما مؤشرات الاختلاف التي تظهر
تندرج الملاحظات ضمن ثلاث مجموعات.
- تظل هوية النموذج الأساسي أقوى مؤشر يمكن استخلاصه. وينطبق ذلك على الفحوص المستهدفة ومجموعة الموجّهات الخارجية على حد سواء.
- تغيّر الموجّهات التي تتضمن شخصيات المفاهيم الظاهرة ضمن بصمات النماذج الأساسية.
- تبرز وحدة ترتيب لا تعرف المصدر مرشحين نادرين، لكنهم مستقرون، لمزيد من الدراسة.
تغيّر الشخصيات طريقة ظهور المفاهيم، لكنها لا تطغى على إشارة النموذج الأساسي. ويعمل الترتيب من دون معرفة المصدر كمرشح للتحليل اللاحق.
معيار عملي: ثبّت النموذج الأساسي أولًا، ثم قيّم أثر الشخصية.
إطار تشخيصي بدلًا من مجرد إثبات التوافق
يقترح المؤلفون النظر إلى تجانس الإجابات المفتوحة بوصفه مسألة تشخيصية. عندها يصبح السؤال مختلفًا: أين تتوافق النماذج، ولماذا تتوافق، وما الذي يمكن كشفه أيضًا؟
- أين تتوافق — خريطة للمفاهيم المتطابقة بين النماذج.
- لماذا تتوافق — الأسباب الكامنة وراء التوافق الظاهري.
- ما الذي يظهر أيضًا — المرشحون الذين يبرزهم الترتيب من دون معرفة المصدر.
نُشرت المقالة في Proceedings of the Third Conference on Language Modeling (COLM 2026)، 2026. وقد قُدّمت إلى arXiv في 29 سبتمبر 2026. المؤلفان هما Ben Wigler وMaria Tsfasman.
المعيار: تجانس الإجابات ليس استنتاجًا نهائيًا، بل مدخلًا لتشخيص العمق.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
اختبار وكلاء البرمجة في تطوير XR التفاعلي: نتائج GenXR-Bench
نُشرت GenXR-Bench، وهي مجموعة تضم 112 مهمة من إعداد خبراء لتقييم وكلاء البرمجة تقييمًا شاملًا في تطوير XR التفاعلي، بدءًا من تحسين الوظائف وإصلاح العيوب وصولًا إلى إنشاء التطبيقات والتحقق من سلوكها على أجهزة استهلاكية. حقق أفضل أداء بين النماذج العشرة التي خضعت للاختبار 50.9% Pass@1؛ وشملت الإخفاقات المتكررة التعامل مع الأحداث غير المتزامنة للمستشعرات، وربط الكائنات بالفضاء الواقعي، وفهم التفاعل في السياق المادي.
5 نوفمبر 2026
من المكافأة القياسية إلى جبهة باريتو: توليف RTL باستخدام النماذج اللغوية الكبيرة والتعلّم المعزّز متعدد المعايير
اقتُرحت طريقة لتدريب نموذج لغوي على توليد مجموعة من مرشّحات RTL بدلًا من مخطط واحد، مع مفاضلات مختلفة بين المساحة وزمن التأخير واستهلاك الطاقة؛ وتُبنى المكافأة على مساهمة كل خيار في حجم فرط جبهة باريتو. على RTLLM v2، ارتفع حجم فرط باريتو النسبي بمقدار 13.3 نقطة مئوية مقارنةً بالإصدار الأساسي من دون تحسين PPA، وبمقدار 14.4 نقطة مئوية مقارنةً بالتدريب بالتعلّم المعزّز ذي الهدف الواحد.
5 نوفمبر 2026
تتعرّف النماذج اللغوية الكبيرة الطبية على تحديثات التوصيات، لكنها غالبًا ما تجيب وفقًا للإرشادات القديمة
أظهرت دراسة ChronoEvo التي شملت 1709 تغييرات في التوصيات السريرية أن النموذج الأساسي رصد التحديث في 90,8% من الإجابات، لكنه طبّقه بالكامل في 58,5% فقط، وظلت فجوة قدرها 32,3 نقطة مئوية قائمة لدى 14 نموذجًا. وحتى تعزيز بروز التحديثات لم يحقق زيادة ملحوظة في التطبيق الكامل للقواعد الجديدة ضمن التوصيات السريرية.
4 نوفمبر 2026