
CEG-Agent: التحليل السببي لإخفاقات آثار وكلاء LLM باستخدام مخططات الأخطاء
يقدّم هذا العمل CEG-Agent، وهو إطار عمل قائم على الأدوات للتشخيص السببي لمسارات تنفيذ الوكلاء. يفصل التصنيف الرسمي بين الحالات الشاذة والأخطاء والإخفاقات، بينما تربط الرسوم البيانية CEG ذات الأنواع أحداث التنفيذ بعُقد التشخيص والإخفاقات النهائية؛ ويؤكد معيار CEG-Bench ريادة هذا النهج من حيث الدقة الدلالية والبنيوية.
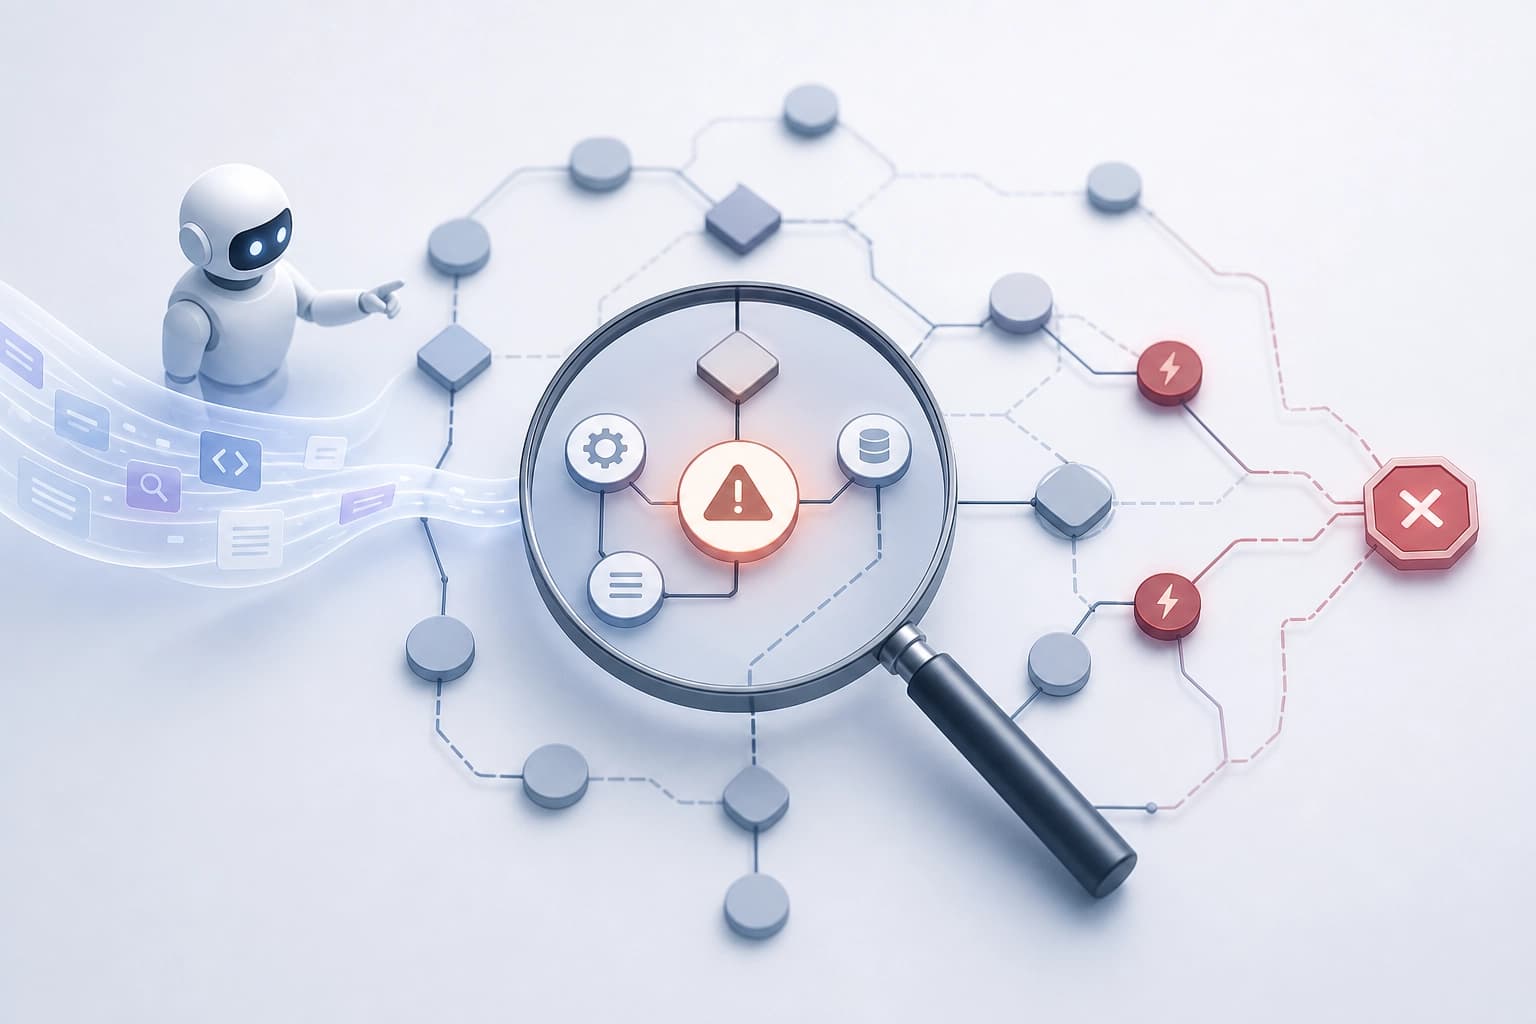
أين يتعثر تشخيص آثار الوكلاء
تستخدم التطبيقات المعقدة وكلاءً قائمين على نماذج اللغة الكبيرة (LLM). وتكون آثار هؤلاء الوكلاء طويلة، مما يصعّب تشخيص حالات الإخفاق.
تمزج أساليب التشخيص الحالية بين الحالات الشاذة والأخطاء والإخفاقات. ونتيجة لذلك، تصبح أهداف التشخيص ملتبسة.
لا تمثّل الأساليب بصورة منظّمة كيفية انتشار الأخطاء ذات الأهمية السببية وتفاقمها. لذلك تظل الإخفاقات النهائية للمهام بلا إسناد موثوق.
المعيار العملي: ينبغي لأسلوب التشخيص أن يفصل بين أنواع الانحرافات ويتتبّع الروابط السببية بينها.
ما هو CEG-Agent
CEG-Agent هو إطار عمل للوكلاء يستخدم الأدوات. ويجري تشخيصًا سببيًا لآثار الوكلاء.
يقدّم إطار العمل تصنيفًا صريحًا للحالات الشاذة والأخطاء والإخفاقات. وانطلاقًا من هذا التصنيف، ينشئ Causal Error Graphs (CEGs).
| النهج | الفصل بين الحالات الشاذة والأخطاء والإخفاقات | نموذج انتشار الأخطاء |
|---|---|---|
| أساليب التشخيص الحالية | تخلط بين هذه المفاهيم | لا تمثّل الانتشار بصورة منظّمة |
| CEG-Agent | يقدّم تصنيفًا صريحًا | ينشئ CEGs بعلاقات سببية |
معيار الاختيار: ينبغي لإطار العمل أن يوفّر أهدافًا تشخيصية واضحة وأن يستند إلى نموذج سببي محدد الأنواع.
Causal Error Graphs: تمثيل سببي محدد الأنواع
CEGs هي تمثيل موحّد محدد الأنواع، يربط عناصر الأثر بعلاقات سببية.
يتضمن الرسم البياني ثلاثة أنواع من العناصر:
- أحداث التنفيذ؛
- عُقد التشخيص؛
- النتائج على هيئة إخفاقات.
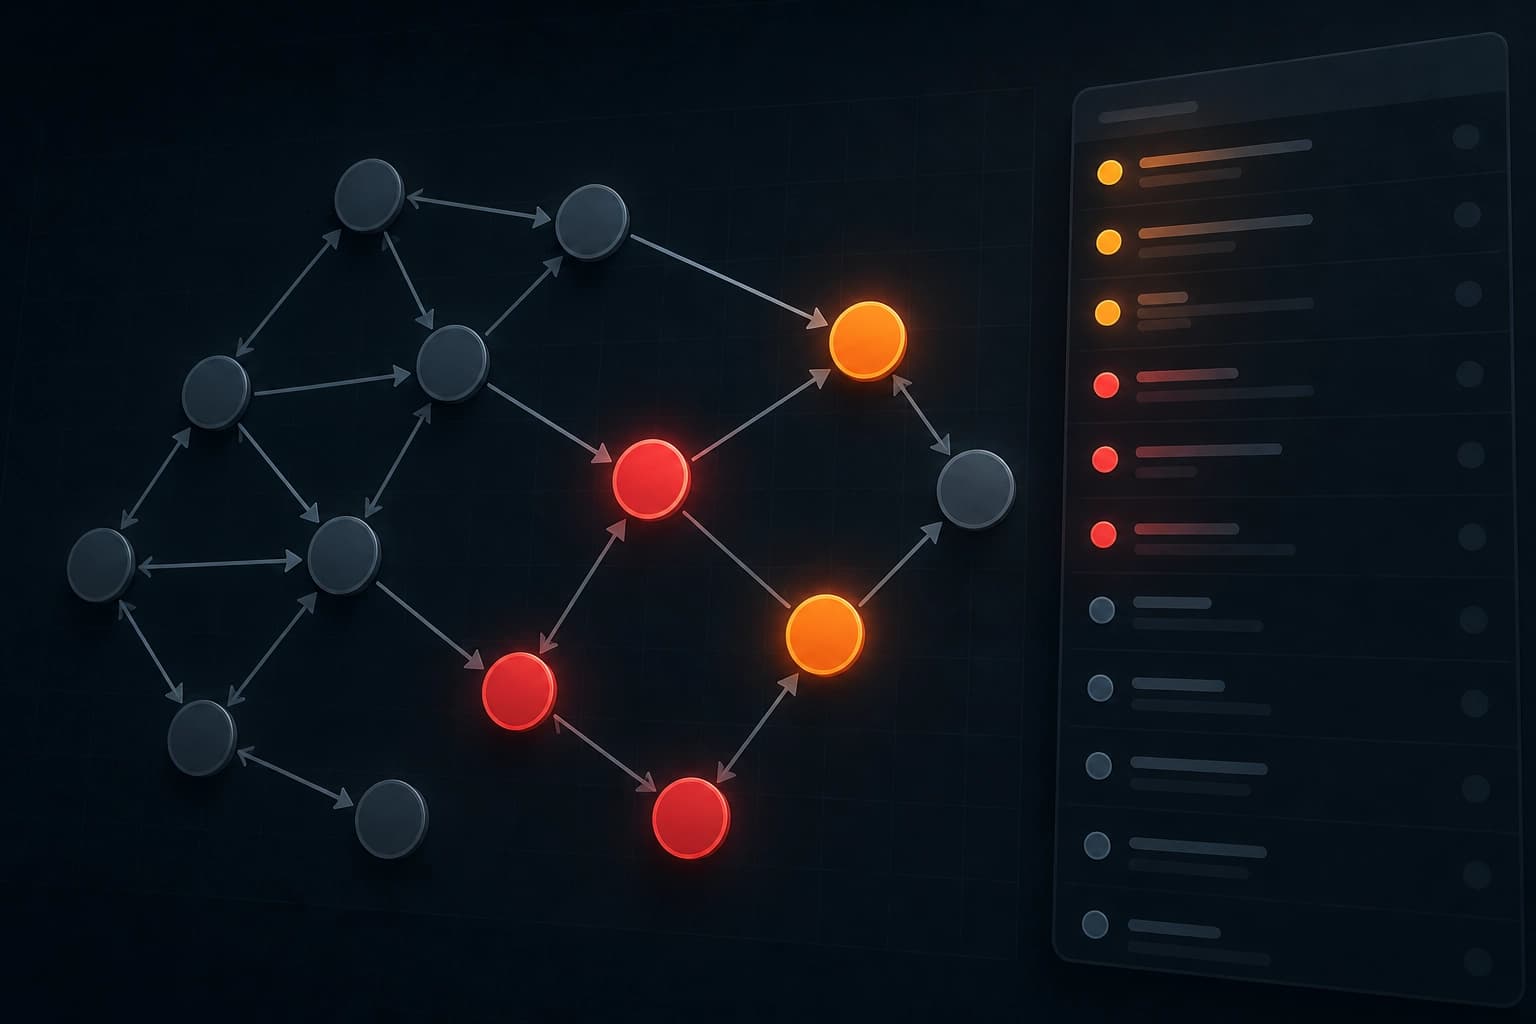
ترتبط جميع العناصر بعلاقات سببية ضمن تنسيق موحّد. وهذا ما يميّز الرسم البياني عن مجموعة من الإشارات المتفرقة.
المعيار: ينبغي للتمثيل أن يربط مسار التنفيذ بالإخفاق النهائي من خلال روابط سببية صريحة.
CEG-Bench والتوسيم عبر AAAP
أُنشئ CEG-Bench لتقييم التشخيص السببي لآثار الوكلاء. وهو معيار مرجعي جرى توسيمه بالكامل بواسطة وكلاء.
أُنتجت التعليقات التوضيحية لـ CEG في المعيار باستخدام Adversarial Agentic Adjudication Protocol (AAAP). وتتميز هذه التعليقات بدرجة عالية من الموثوقية والاتساق.
جرى التحقق من التعليقات التوضيحية بمقارنتها بمجموعة مرجعية بشرية أعدّها خبراء. وأظهرت التعليقات التوضيحية الآلية توافقًا وثيقًا مع تعليقات الخبراء.
المعيار: يصلح المعيار المرجعي الذي جرى التحقق من توسيمه بمقارنته بمرجع بشري لمقارنة أساليب التشخيص السببي.
النتائج ومعيار الاختيار
في التجارب على CEG-Bench، يحقق CEG-Agent نتائج تُضاهي أحدث ما توصلت إليه التقنيات. وجرت عملية التقييم وفق معيارين.
المعيار الأول هو التقييم المخفف دلاليًا. والثاني هو التقييم الدقيق بنيويًا. ويحقق إطار العمل نتائج تُضاهي أحدث ما توصلت إليه التقنيات وفق كلا المعيارين.
معيار الاختيار: إذا كانت المهمة تتطلب صحة دلالية وبنيوية في التحليل، فليكن الأسلوب الذي يحقق هذا المستوى من النتائج مرجعًا للاختيار.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
تتعرّف النماذج اللغوية الكبيرة الطبية على تحديثات التوصيات، لكنها غالبًا ما تجيب وفقًا للإرشادات القديمة
أظهرت دراسة ChronoEvo التي شملت 1709 تغييرات في التوصيات السريرية أن النموذج الأساسي رصد التحديث في 90,8% من الإجابات، لكنه طبّقه بالكامل في 58,5% فقط، وظلت فجوة قدرها 32,3 نقطة مئوية قائمة لدى 14 نموذجًا. وحتى تعزيز بروز التحديثات لم يحقق زيادة ملحوظة في التطبيق الكامل للقواعد الجديدة ضمن التوصيات السريرية.
4 نوفمبر 2026
نموذج العالم للوكلاء الذين يستخدمون نماذج لغوية كبيرة مغلقة: التصحيح عند نقاط الخطر
اقتُرحت PAWM بوصفها أداة تنبؤ خارجية لا تكرر المراقبة خطوة بخطوة، بل تتدخل عند احتمال حدوث إخفاق وتُبعد الوكيل عن الإجراء الخاطئ. بعد الضبط الدقيق المُشرف (SFT) على سيناريوهات اصطناعية والتدريب المشترك باستخدام GRPO، حققت الطريقة تحسنًا بنسبة 24.3% في ScienceWorld و7.7% في WebArena-Lite مع Claude Sonnet 4.5.
4 نوفمبر 2026
طبقة تصنيفية فوق SpeechLLM: أين تتفوق على توليد التسميات في التعرّف على المشاعر
باستخدام مجموعتي IEMOCAP وMELD، جرت مقارنة التنبؤ التوليدي بالوسم العاطفي بالمُصنِّف الخطي الذي يعمل على التمثيلات الكامنة لنموذج SpeechLLM صغير. ولا يكون التحسن في الأداء الناتج عن المُصنِّف عامًا؛ إذ يعتمد على مجموعة البيانات وعلى استخدام النصوص المرجعية أو مخرجات التعرّف الآلي على الكلام (ASR).
4 نوفمبر 2026