
CARAT: يختبر ما إذا كانت نماذج اللغة الكبيرة المتخصصة في علم المواد تستنتج البنية أم تعيد صياغة الموجّه
يقترح هذا العمل بروتوكولًا يثبّت السؤال والإجابة المرجعية عبر ثماني طرق لتقديم البنية، ويعلّم الروابط في GraphSpace بشكل منفصل. وتُظهر التجارب على الضبط الدقيق المزدوج، وحجب الحقول المستهدفة، وإضافة الشواهد، أن النموذج قادر على تعلّم تطبيق العلاقة واتباع الرابط، إلا أن إزالة الرابط تخفض الدقة إلى ما دون مستوى أساليب التصفح الاستدلالية.
لماذا لا تثبت الدقة القدرة على الاستدلال
قد يعطي نموذج لغوي لمجال علم المواد إجابة صحيحة لسببين مختلفين. فإما أن يستنتجها من البيانات البنيوية، أو أن يعيد إنتاج قيمة موجودة أصلًا في المُدخل. ولا تميّز مقاييس الدقة المعتادة بين هاتين الحالتين. فقد يتضمن الوصف البنيوي حقلًا تُقيَّم الإجابة بناءً عليه، وعندئذ تعكس الدرجة قراءة التلميح.
يتمحور معيار CARAT حول هذا التمييز. فهو يتحقق مما إذا كانت النماذج اللغوية الكبيرة في مجال علم المواد تستدل انطلاقًا من البيانات البنيوية أم تكتفي بإعادة صياغة التلميح. مؤلفو الورقة هم Jiajun Wu وJian Yang وZixiang Ni وZhenzhu Li وBin Chong؛ وقد قُدّم العمل في 29 سبتمبر 2026.
المعيار العملي: الدقة العالية على البيانات البنيوية لا تثبت شيئًا في حد ذاتها. المهم هو الظروف التي جرى فيها التوصل إلى الإجابة.
كيف تجري المقارنة المناظرة
يبقى السؤال والإجابة المرجعية ثابتين عبر ثمانية تمثيلات مناظرة. وتُحدَّد العلاقات البنيوية بشكل منفصل في GraphSpace.
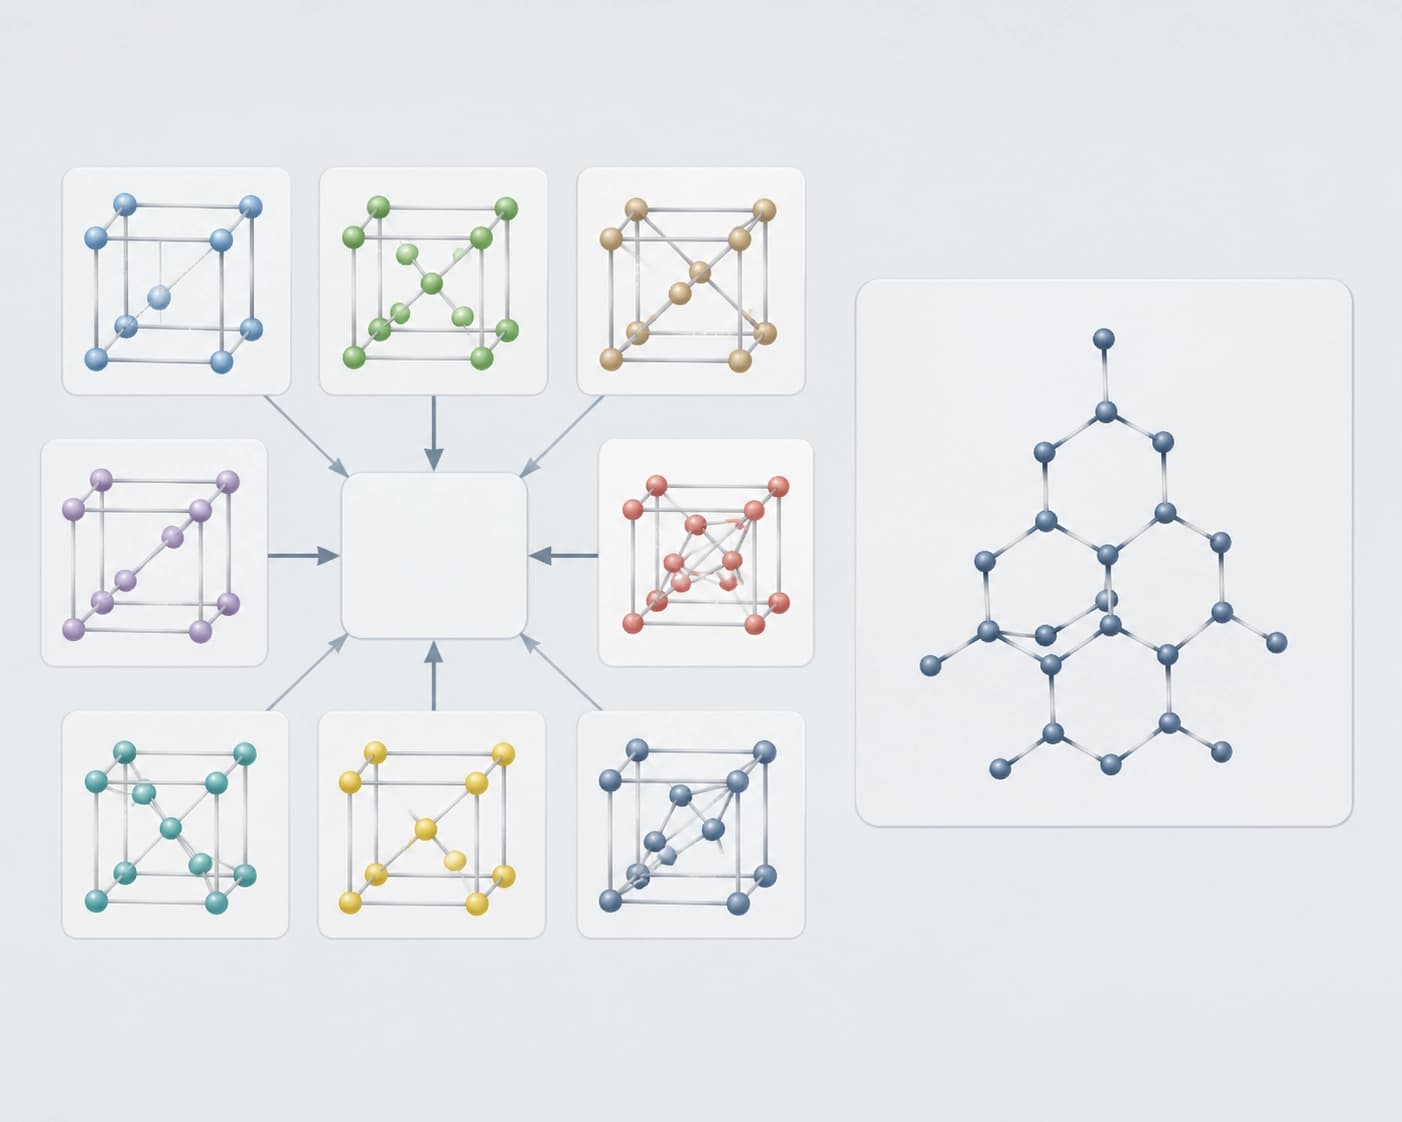
ويُضاف إلى ذلك ضبط دقيق مناظر، وحجب الإجابات، وإضافة الشواهد، والاستدلال المزدوج، وقاعدة تتيح الامتناع عن الجزم.
| ما الذي تتم مقارنته | الفرق |
|---|---|
| تمثيل يستند إلى البنية مقابل إدخال الصيغة فقط، في أصعب مجموعات المهام | 17.3 نقطة |
إبقاء السؤال ثابتًا يزيل التفسير القائم على صياغة المهمة. أما حجب الإجابات فيمنع النموذج من إدراج قيمة جاهزة.
الخلاصة: لا تجدي مقارنة التمثيلات إلا إذا ظل السؤال والإجابة المرجعية ثابتين. وإلا فسيعكس الفرق جودة نص المهمة، لا التعامل مع البنية.
ما مقدار الفجوة بين GraphSpace والرسم البياني البسيط
يتفوق GraphSpace على الرسم البياني الدوري البسيط بمقدار 19.3 نقطة. وتتألف هذه الفجوة من تأثيرين مختلفين.
| الحالة | الفرق |
|---|---|
| يحتوي التمثيل البسيط على كل ما يلزم للإجابة | 1.96 نقطة |
| تخلو البنية البسيطة تمامًا من هذه الحقول | 46.7 نقطة |
عندما يكون التمثيل الأساسي كافيًا للإجابة، تكاد الأفضلية تختفي. أما عندما تخلو البنية من الحقول المطلوبة، فتتسع الفجوة. ويشير المؤلفون إلى أن النتيجة الرئيسية للمقارنة تعكس نقص البيانات في التمثيل الأساسي، لا طريقة تمثيل الشواهد.
المعيار العملي: تحقّقوا من الحقول الموجودة في التمثيل قبل استنتاج تفوق تمثيل على آخر. وإلا فسيكون ما يُقاس هو اكتمال البيانات، لا المنهج.
الاستراتيجيات الالتفافية وإعادة تصميم المعيار
كشف الاختبار عن نقطة ضعف في مجموعة المهام. فالقاعدة التي تتجاوز الرابط وتقرأ القائمة مباشرة تجيب عن أربع من مجموعات المهام السبع المعقدة. وقد يتجاوز النموذج العلاقة ببساطة بدلًا من فهمها.
أُعيد تصميم المعيار. وأصبحت إحدى عشرة استراتيجية التفافية من هذا النوع تحقق نتائج قريبة من التخمين العشوائي.
الخلاصة: لا تصلح مجموعة المهام لتقييم الاستدلال إلا بعد اختبارها للكشف عن المسارات الالتفافية. فإذا نجحت قاعدة بسيطة في حل بعض المجموعات، فهذا لا يقيس الاستدلال.
ذكر الرابط في الإجابة والاستناد إلى العلاقة
يقتبس النموذج غير المضبوط الرابط، لكنه يعطي الإجابة نفسها في 95.6% من الحالات المقترنة عند إعادة توجيه الرابط. فهو يكرر العلاقة من دون استخدامها.
| الحالة | نسبة الحالات المقترنة التي تطابقت فيها الإجابة |
|---|---|
| نموذج غير مضبوط، مع إعادة توجيه الرابط | 95.6% |
| بعد التدريب المناظر، مع إعادة توجيه الرابط | 99.8% |
| حذف الرابط | 23.4% |
| أفضل استراتيجية التفافية | 27.0% |
بعد التدريب المناظر، يصل المؤشر إلى 99.8%. ويؤدي حذف الرابط إلى خفضه إلى 23.4%، وهي نسبة أدنى من 27.0% التي تحققها أفضل استراتيجية التفافية. ويخلص المؤلفون إلى أن خطوتَي التدريب كلتيهما — استخدام العلاقة والاستناد إلى الرابط — قابلتان للتعلّم.
المعيار: اقتباس الرابط لا يعني استخدامه. وينبغي اختبار سلوك النموذج عند إعادة توجيه الرابط وعند حذفه.
ما الذي يعنيه ذلك لتقييم الأدوات
- تحقّقوا مما إذا كان المُدخل يتضمن الإجابة الجاهزة عن السؤال المطروح.
- انظروا إلى النتائج عند إعادة توجيه الرابط وحذفه، لا إلى الاقتباس وحده.
- اطلبوا وصفًا لعناصر الضبط: سؤال ثابت، وإجابة مرجعية ثابتة، وعدة تمثيلات.
- استفسروا عما إذا كانت مجموعة المهام قد حُدّثت بعد اختبارها للكشف عن الاستراتيجيات الالتفافية.
- قيّموا الفجوة المعلنة بالاقتران مع مكونات البيانات، لا كرقم مستقل.
معيار الاختيار: تستحق النتيجة الثقة إذا تعذّر تفسيرها بوجود الحقل المطلوب في التلميح أو بتطبيق قاعدة التفافية بسيطة.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
اختبار وكلاء البرمجة في تطوير XR التفاعلي: نتائج GenXR-Bench
نُشرت GenXR-Bench، وهي مجموعة تضم 112 مهمة من إعداد خبراء لتقييم وكلاء البرمجة تقييمًا شاملًا في تطوير XR التفاعلي، بدءًا من تحسين الوظائف وإصلاح العيوب وصولًا إلى إنشاء التطبيقات والتحقق من سلوكها على أجهزة استهلاكية. حقق أفضل أداء بين النماذج العشرة التي خضعت للاختبار 50.9% Pass@1؛ وشملت الإخفاقات المتكررة التعامل مع الأحداث غير المتزامنة للمستشعرات، وربط الكائنات بالفضاء الواقعي، وفهم التفاعل في السياق المادي.
5 نوفمبر 2026
من المكافأة القياسية إلى جبهة باريتو: توليف RTL باستخدام النماذج اللغوية الكبيرة والتعلّم المعزّز متعدد المعايير
اقتُرحت طريقة لتدريب نموذج لغوي على توليد مجموعة من مرشّحات RTL بدلًا من مخطط واحد، مع مفاضلات مختلفة بين المساحة وزمن التأخير واستهلاك الطاقة؛ وتُبنى المكافأة على مساهمة كل خيار في حجم فرط جبهة باريتو. على RTLLM v2، ارتفع حجم فرط باريتو النسبي بمقدار 13.3 نقطة مئوية مقارنةً بالإصدار الأساسي من دون تحسين PPA، وبمقدار 14.4 نقطة مئوية مقارنةً بالتدريب بالتعلّم المعزّز ذي الهدف الواحد.
5 نوفمبر 2026
تتعرّف النماذج اللغوية الكبيرة الطبية على تحديثات التوصيات، لكنها غالبًا ما تجيب وفقًا للإرشادات القديمة
أظهرت دراسة ChronoEvo التي شملت 1709 تغييرات في التوصيات السريرية أن النموذج الأساسي رصد التحديث في 90,8% من الإجابات، لكنه طبّقه بالكامل في 58,5% فقط، وظلت فجوة قدرها 32,3 نقطة مئوية قائمة لدى 14 نموذجًا. وحتى تعزيز بروز التحديثات لم يحقق زيادة ملحوظة في التطبيق الكامل للقواعد الجديدة ضمن التوصيات السريرية.
4 نوفمبر 2026