
CaLR: التحسين الكامن مع قيود سببية لاستدلال مستقر لنماذج الانتشار
يقدّم العمل CaLR، وهو نهج يحوّل الاستدلال إلى مسألة تحسين مقيّدة في الفضاء الكامن؛ إذ تستمد البنية من مصفوفة طوبولوجيا سببية مستمدة من نموذج خبير، ويعتمد التدريب على التفاضل الضمني. يعزز الأسلوب الاتساق ويتيح تصحيح النتائج الوسيطة أثناء التوليد المتوازي، ما يحقق أداءً أفضل على مجموعات البيانات المعقدة وفي المهام ذات القيود الصارمة، بما فيها السودوكو.
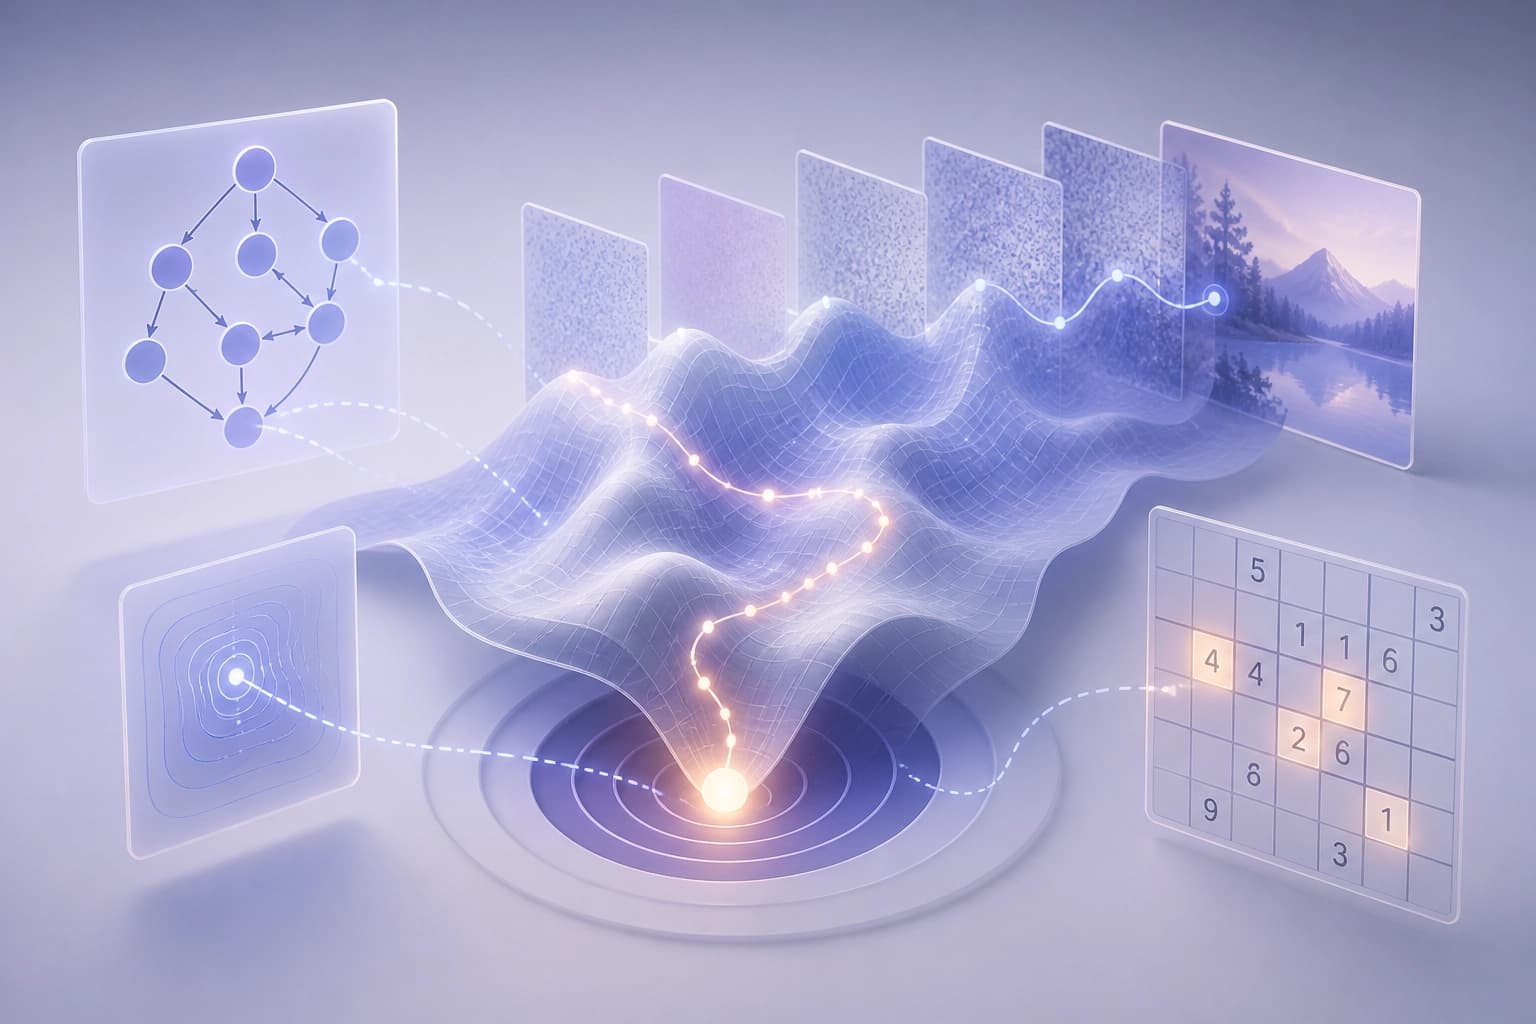
المشكلة: الجشع المحلي في AR وضعف السببية في DLM
تعاني النماذج ذاتية الانحدار من الجشع المحلي. وغالبًا ما تفتقر نماذج اللغة الانتشارية إلى بنية سببية صارمة للاستدلال.
| نوع النموذج | القيد |
|---|---|
| AR | الجشع المحلي |
| DLM | نقص البنية السببية الصارمة للاستدلال |
الخلاصة: يتطلب الاستدلال آلية تربط التوليد بالقيود السببية. المعيار العملي: التحقق من قدرة النموذج على الحفاظ على البنية المنطقية في الخطوات الوسيطة.
الإطار ومهمته
CaLR هو إطار للاستدلال المستقر لنماذج الانتشار. ويصوغ الاستدلال على أنه تحسين كامن مقيّد. الاسم الكامل: «CaLR: Causal Latent Revision for Robust Diffusion Reasoning». المؤلفون: Wei Cai, Jian Zhao, Yuchen Yuan, Xuelong Li. تاريخ التقديم: 17 سبتمبر 2026.
الخلاصة: يربط CaLR الاستدلال المستقر بتحسين التمثيل الكامن. المعيار العملي: اختيار الطريقة إذا كانت المهمة تتطلب بنية سببية في الاستدلال.
مكوّنات النهج
يستخدم CaLR ثلاثة عناصر. الأول هو مصفوفة الطوبولوجيا السببية (CTM). ويحصل على المصفوفة من نموذج خبير. والثاني هو التفاضل الضمني. والثالث هو «مراجعة الأفكار» الموجّهة بالتدرّج.
مصفوفة الطوبولوجيا السببية (CTM)
CTM هي مصفوفة طوبولوجية سببية. ومصدرها نموذج خبير.
التفاضل الضمني
يستخدم CaLR التفاضل الضمني.
«مراجعة الأفكار» الموجّهة بالتدرّج
تهدف هذه العملية إلى ضمان الاتساق المنطقي. كما تهدف إلى التصحيح الذاتي الديناميكي للخطوات الوسيطة أثناء التوليد المتوازي.
الخلاصة: توفر CTM البنية السببية، ويدخل التفاضل الضمني في عملية التحسين، وتصحّح مراجعة الأفكار الخطوات. المعيار العملي: التحقق من وجود مصدر للبنية السببية وآلية للتصحيح.
النتائج المُعلنة
يحقق CaLR أداءً بمستوى SOTA لنماذج DLM على معايير صعبة. ويتفوق الإطار على خطوط أساس قوية من AR. كما يُظهر استقرارًا معززًا في المهام ذات القيود، مثل سودوكو.
| الخاصية | النتيجة |
|---|---|
| أداء DLM | SOTA على معايير صعبة |
| المقارنة مع AR | يتفوق على خطوط أساس قوية من AR |
| الاستقرار | استقرار معزز في المهام ذات القيود، مثل سودوكو |
الخلاصة: تتعلق المزايا المُعلنة بالمعايير الصعبة والمهام ذات القيود. المعيار العملي: مواءمة متطلبات المهمة مع الاستقرار في المهام ذات القيود. ولا تتضمن ملخصات البيانات معلومات عن السيناريوهات الأخرى.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
الثوابت كثيرة الحدود القانونية في تشخيص أعطال محاكيات التعلم المعزز: أين تكون مفيدة حقًا
تبحث الدراسة مدى جدوى إدراج القوانين الفيزيائية في نماذج الديناميكيات المتعلَّمة: فالثوابت المستخلصة من المسارات والمحوَّلة إلى صيغة معيارية باستخدام قواعد غروبينر تحقق تحسناً متواضعاً في التنبؤات، لكنها فعّالة في التشخيص، إذ تتيح تحديد موضع القيد المنتهك والكشف عن المعلمة الخاطئة بعينها.
10 نوفمبر 2026
AURA-Eval: كيفية التحقق من أن وكيل LLM قد أدرك المخاطر وغيّر خطوته التالية
يقيّم هذا الإطار سلوك وكلاء LLM لا استنادًا إلى الحكم النهائي، بل إلى استجابتهم للمخاطر عند نقاط محورية: إذ تُقطع مسارات استدعاء الأدوات، ثم يُطلب من النموذج مواصلة الاستدلال والتصرف، بينما تحلل لجنة من محكّمي LLM رصد المخاطر وطبيعة الخطوة ومدى أمانها. وفي 1249 مهمة جُمعت من 157 مسارًا لـ R-Judge، ازداد تواتر التصرفات غير الآمنة لدى 20 نموذجًا عند غياب مسار آمن، كما أدى رفع الإشراف قبل التنفيذ إلى تحويل 52,3% من الحالات الآمنة في الأصل إلى حالات غير آمنة.
10 نوفمبر 2026
ذاكرة خزان تشيرن-سايمونز: ديناميكيات الترابط الذاتية ونقل الكثافة
تتناول المقالة كيفية احتفاظ الخزان بتاريخ الإشارات الواردة في كلٍّ من توزيع الكثافة ودرجات الحرية الهندسية. وتُظهر مقارنة أربعة آليات أن التيار ينشئ مكوّنًا منفصلًا من مكوّنات الاتصال، يغيّر استجابة الكثافة لاحقًا، وأن أخذ جميع السمات المقاسة في الحسبان يحقق تحسنًا طفيفًا في فك ترميز ترتيب النبضات.
10 نوفمبر 2026