
مدى متانة الكواشف أمام النصوص المُولَّدة آليًا بعد إعادة صياغتها: ما الذي كشفته الاختبارات
يجمع هذا المقال نتائج اختبارات أدوات تعيد صياغة المقاطع المُولّدة بأسلوب أكثر طبيعية. وبعد هذه المعالجة، تنخفض إمكانية اكتشافها بشكل ملحوظ، فيما تحول النتائج الإيجابية الكاذبة المتبقية دون اعتبار حكم الكاشف دليلًا قاطعًا.
كيف تغيّر إعادة الصياغة النص وإشارات الكواشف
المحتوى الذي صقله الذكاء الاصطناعي هو نص آلي أُعيدت صياغته ليبدو أكثر طبيعية. تغيّر الأدوات اختيار الكلمات وطول الجمل والنبرة. وتضيف بعضها إيقاعًا غير منتظم أو تعيد كتابة النص مرات عديدة. وتغيّر هذه التعديلات الإشارات التي تعتمد عليها الكواشف: مدى قابلية الكلمات للتنبؤ وتنوع أطوال الجمل.
- اختيار الكلمات؛
- طول الجمل؛
- النبرة؛
- الإيقاع غير المنتظم؛
- إعادة الكتابة مرات عديدة.
الخلاصة: تغيّر إعادة الصياغة السمات نفسها التي تميّز بها الكواشف النص الآلي.
ما الذي أظهرته اختبارات النصوص المعاد صياغتها
اختبرت التجارب مدى حفاظ الكواشف على موثوقيتها بعد إعادة الصياغة. وشملت دراسة أُجريت عام 2025 عددًا من أدوات صقل النصوص وإعادة صياغتها بلغ 19 أداة.
| الاختبار | النتيجة |
|---|---|
| دراسة عام 2025، 19 أداة | لا تتعرف كثير من الكواشف على النص المصقول. |
| Google Research | يحافظ نموذج إعادة الصياغة على المعنى ويتجنب الكشف إلى حد كبير. |
| إعادة صياغة ChatGPT باستخدام QuillBot | انخفضت دقة الكاشف على نص ChatGPT إلى 49%. |
| اختبار آخر | تجاوزت إعادة صياغة ChatGPT كل كاشف في نصف الحالات على الأقل. |
| Stanford، اللغة الأدبية | انخفض كشف النصوص المولّدة بالذكاء الاصطناعي من 100% إلى 13% عندما طُلب من ChatGPT استخدام لغة أدبية أكثر. |
الخلاصة: موثوقية الكواشف في التعرّف على النص الآلي المعاد صياغته منخفضة.
ما الذي ترصده الكواشف في النص
تعتمد الكواشف على سمات لا ترتبط دائمًا بالأصل الآلي للنص. ووجد باحثون في Carnegie Mellon أن نصوص النماذج الأساسية بدت مكتوبة بشريًا في نظر GPTZero وPangram، بينما لم تبدُ كذلك نصوص النماذج التي خضعت لضبط إضافي لاتباع التعليمات. ويرى الفريق أن الكواشف ترصد آثار تدريب النموذج أكثر مما ترصد مؤشرًا موثوقًا على الكتابة الآلية.
- النماذج الأساسية: غالبًا ما تبدو نصوصها بشرية في نظر GPTZero وPangram؛
- النماذج التي خضعت لضبط إضافي لاتباع التعليمات: لا تبدو نصوصها كذلك؛
- خلاصة الفريق: ترصد الكواشف آثار التدريب.
اختبرت Stanford سبعة كواشف على 91 مقالة كتبها أشخاص ليست الإنجليزية لغتهم الأم. وبلغ متوسط معدل الإيجابيات الكاذبة 61,3%. وأشارت أداة واحدة على الأقل إلى أكثر من 91% من المقالات. أما المقالات التي كتبها أشخاص لغتهم الأم الإنجليزية، فسجّلت معدلات قريبة من الصفر. ويربط الباحثون هذا الاختلاف باختيار الكلمات البسيط والمتوقع، الذي تعتبره الكواشف نصًا آليًا.
الخلاصة: إشارة الكاشف لا تعني أن النص من إنتاج آلة، لذا يتطلب التقييم مراعاة السياق.
الدقة المعلنة والقيود الفعلية
تقدّم الاختبارات المستقلة واختبارات الجهات المطوّرة تقديرات مختلفة للدقة. وتؤثر ظروف الاختبار في النتيجة.
- مراجعة للاختبارات المستقلة: تتراوح دقة Turnitin وGPTZero وOriginality.ai بين 70% و85%. وتظل مشكلة الإيجابيات الكاذبة قائمة لدى هذه الأدوات.
- تعلن Turnitin أن دقتها تبلغ 98%، وأن معدل الإيجابيات الكاذبة أقل من 1%. وينطبق هذا الادعاء فقط على المستندات التي أنشأ الذكاء الاصطناعي أكثر من 20% من نصها.
- أغلقت OpenAI مصنّفها الخاص في يوليو 2023. ولم يكن المصنّف يتعرف إلا على 26% من النصوص التي أنشأها الذكاء الاصطناعي.
- درّب مؤلفو دراسة عام 2025 نموذجًا على عينات مصقولة. وتمكّن النموذج من التعرّف على النص المصقول مع معدل منخفض من الإيجابيات الكاذبة. كما حافظ على فعاليته رغم محاولات خداعه. وقد حصل مؤلفو النموذج أنفسهم على هذه النتائج؛ وما زالت هناك حاجة إلى اختبارات مستقلة.
الخلاصة: تعتمد الدقة المعلنة على ظروف الاختبار، فيما تكشف الاختبارات المستقلة حدود إمكانات الكشف.
التقييم العملي للكاشف
يوصي الخبراء بالتعامل مع نتيجة الكاشف باعتبارها مؤشرًا لا دليلًا قاطعًا. ويمكن للتحقق أن يشمل مراجعة سجل المسودات، وطرح أسئلة شفهية قصيرة، ومقارنة النص بأعمال أُنجزت داخل الصف. وينصح الخبراء المؤلفين والناشرين بطلب المصادر والمقابلات والبيانات الأصلية.
- سجل المسودات؛
- أسئلة شفهية قصيرة؛
- المقارنة بأعمال أُنجزت داخل الصف؛
- المصادر والمقابلات والبيانات الأصلية للمؤلفين والناشرين.
المعيار العملي: الكاشف مؤشر يدعو إلى مزيد من التحقق، وليس الأساس الوحيد للاستنتاج.
الأسئلة المتكررة
المواد ذات الصلة
جميع المواد
FedSocket: نماذج قابلة للتبادل مع اشتراط إمكانية تنفيذها لدى المستلِم في ظل التباين متعدد الوسائط
يُقدَّم FedSocket بوصفه نهجًا يشترط أن يكون النموذج المتبادل قابلًا للتشغيل على جهة المستلِم، ويربط بين النماذج الخاصة المتباينة واجهةُ تنبؤات مشتركة تُسمى Q. وتصف المقالة التجميع مع مراعاة الانتماء، وإرسال معلمات Q وحدها إلى جانب العدّادات، وتجارب على ست مجموعات بيانات تُظهر تحسن الدقة عند غياب بعض الوسائط وتفوّق الاستدلال المشترك (Joint) على التجميعات المستقلة.
13 نوفمبر 2026
CyberArena: مواجهات ثنائية بين وكلاء الذكاء الاصطناعي تكشف حدود المعايير السيبرانية الثابتة
يضع المعيار وكيلين في بيئات معزولة تضم خدمات تتغير باستمرار، ثم يحوّل أفعالهما على مدار سلسلة من الجولات إلى درجات متعددة الأبعاد للمهارات الهجومية والدفاعية. وفي 466 مباراة شملت 12 نموذجًا متطورًا، ميّز بين القدرات في الحالات التي تبلغ فيها الاختبارات أحادية الجانب سقفها، بما في ذلك التخطيط لعدة خطوات وإنشاء الأبواب الخلفية.
13 نوفمبر 2026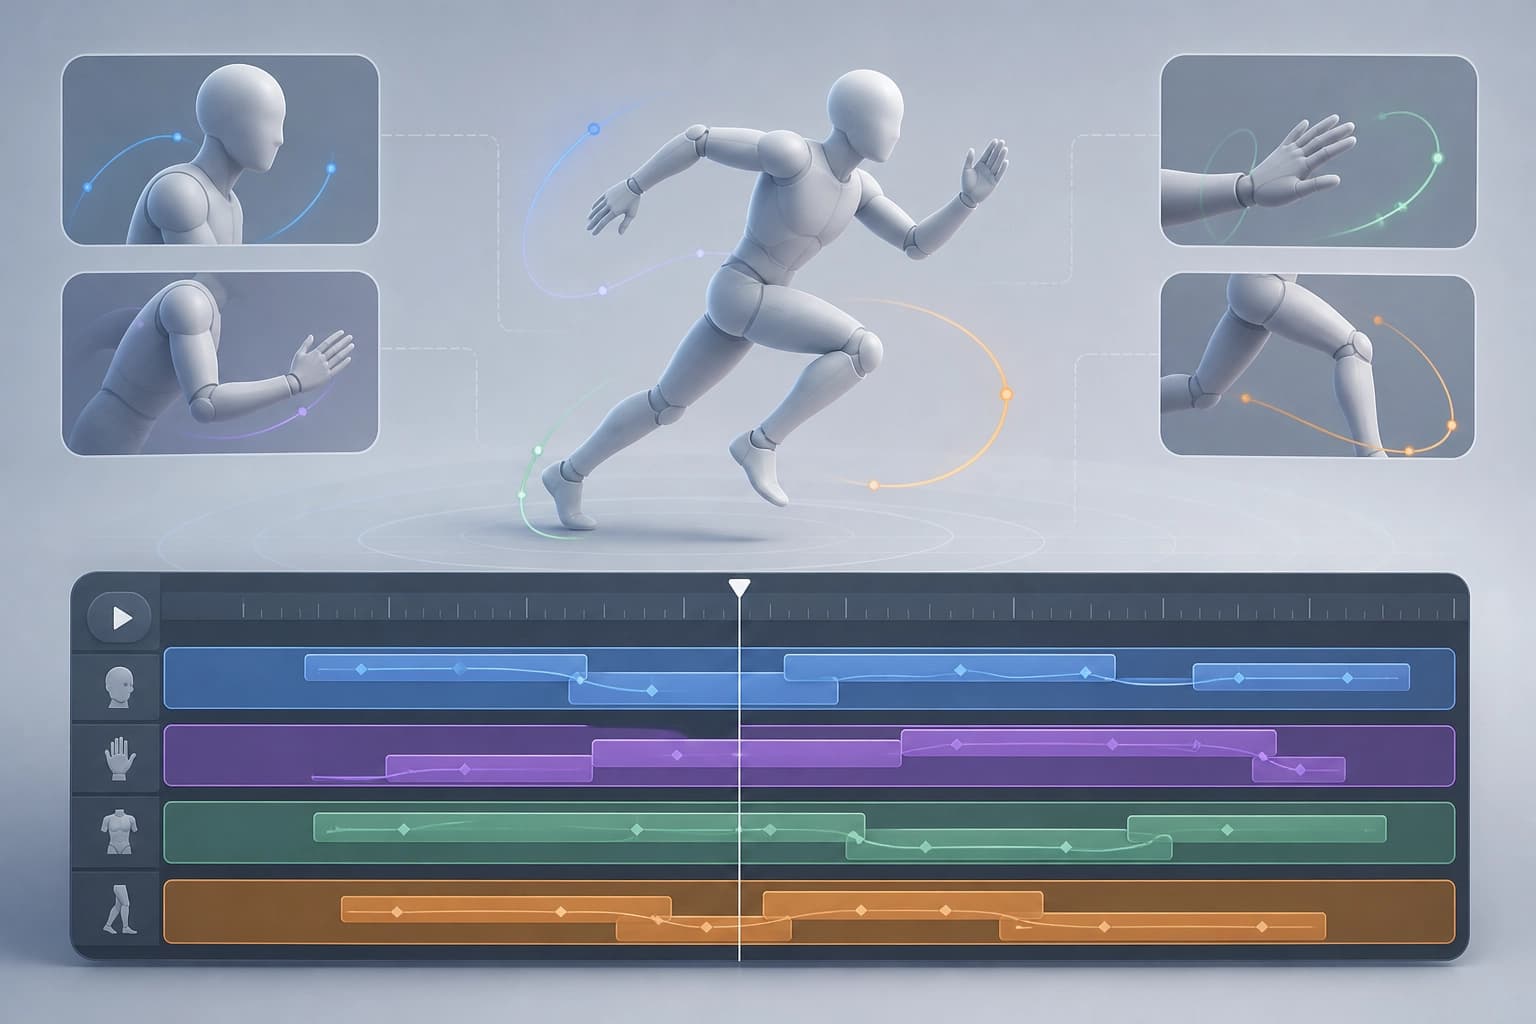
أوامر جديدة أثناء التوليد: مخطط زمني متعدد المسارات للحركات البشرية ثلاثية الأبعاد
تُقترح طريقة تقبل تعليمات نصية جديدة أثناء التوليد، وتتيح تحديد فترات زمنية متداخلة للحركات بشكل مستقل. ويُضمن تنسيق الحركات المتزامنة لأجزاء الجسم المختلفة من خلال التكييف على الفترات الزمنية وإجراء إزالة الضوضاء المراعي لأجزاء الجسم؛ وعلى TimelineMotion وMTT، يفيد المؤلفون بتحقيق توافق أفضل مع الدلالات والقيود الزمنية مقارنةً بالحلول الأساسية المتدفقة.
12 نوفمبر 2026