المكافأة القائمة على النتيجة — والمنطقة العمياء بداخلها
في أبحاث وكلاء واجهات المستخدم الرسومية (GUI)، حدث تحوّل ملحوظ في التركيز: صارت أعمال أكثر مكرّسة لنمذجة المكافأة القائمة على النتيجة (outcome reward modeling). المنطق بسيط — يحصل الوكيل على درجة بناءً على ما إذا كان مساره قد أدى إلى الحالة التي قصدتها تعليمات المستخدم. هناك إجراء، وهناك شاشة، وهناك نتيجة، وهناك تقييم.
لكن هنا يكمن المأزق. إذا حصل الوكيل على مكافأة «على النتيجة»، فلا بد أن يصوغ أحدهم ما الذي يُعدّ تحديدًا نتيجة. في المخطط النموذجي، إما أن تُتخطى هذه الخطوة باستبدالها بصياغة عامة، أو تُترك لتقدير النموذج نفسه: فهو «يستنتج» أثناء التحقق، دون معايير مثبّتة صراحةً. وكلا الأمرين يبدو عمليًا إلى أن يصبح المطلوب تقييم عشرات المهام المختلفة بالمدقّق نفسه.
ثلاثة أخطاء نمطية في المعايير المعمّمة
يصف مؤلفو ورقة arXiv:2608.24174 «Task-Adaptive Rubrics for GUI Reward Modeling» (Tao Xiong والمشاركون) إلى ما يؤدي الاعتماد على قالب شامل أو على استنتاج النموذج الضمني. المشكلات متوقعة:
- نقل الفحوص بين المهام. يُطبَّق معيار وُضع يومًا ما لسيناريو معيّن آليًا على سيناريو آخر لا معنى له فيه أصلًا.
- فقدان القيود. المتطلبات المحددة للتعليمة الحالية — القيم المطلوبة، الحقول المعيّنة، الخطوات المحددة — تبقى دون ملاحظة، لأن المعيار العام لا يميّزها.
- صرامة مفرطة. يبدأ المدقّق بطلب ما لم يطلبه المستخدم، ويرفض مهمة نُفّذت بشكل صحيح.
السبب المشترك بين الثلاثة واحد: المعيار يعيش منفصلًا عن المهمة. فهو لا يُستخرج من التعليمة، بل يُلحق بها من الخارج.
كيف يعمل AdaptRubric
الإطار المقترح يحمل هذا الاسم — إطار المعايير «من الخشن إلى الدقيق» (Coarse-to-Fine Rubrics Framework). مهمته ليست تخزين مجموعة جاهزة من المعايير، بل بناؤها لكل تعليمة محددة، متحركًا من المستوى الواسع إلى الضيق. مرحلتان تعالجان مشكلتين مختلفتين، وهذه تفصيلة أساسية في البنية.
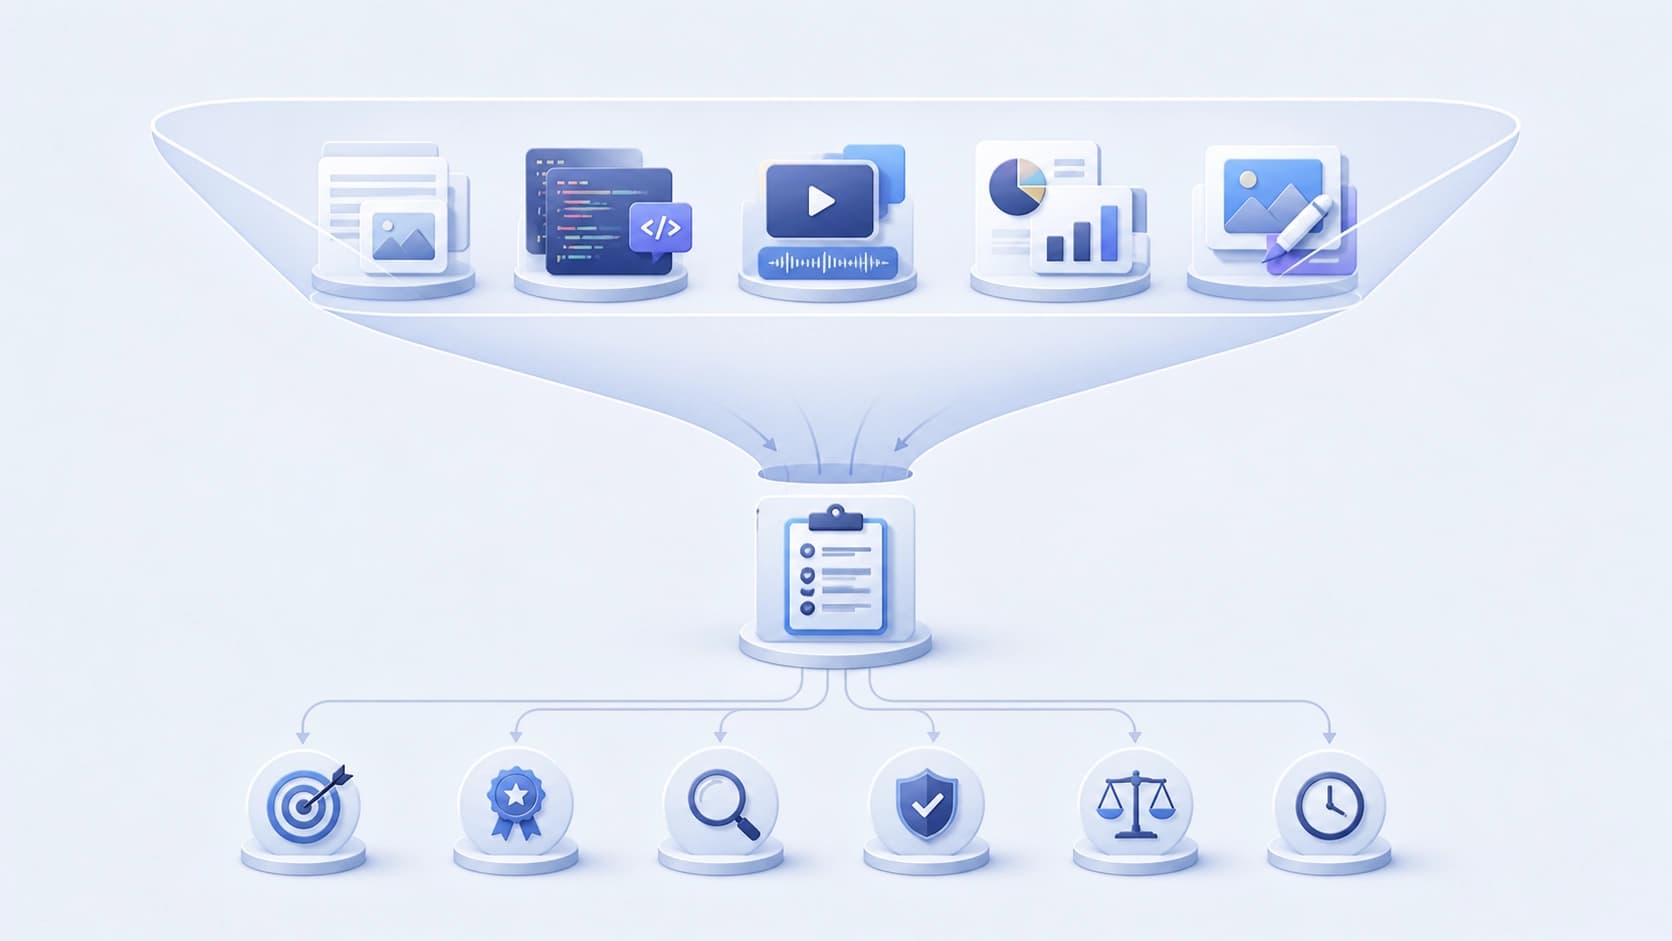
المرحلة الخشنة: أولًا فهم فئة المهام
الخطوة الأولى هي التوجيه. تُنسب التعليمة إلى عائلة معيّنة من مهام واجهات المستخدم الرسومية، ومن هذه العائلة تُستدعى معايير قابلة لإعادة الاستخدام. المعنى أن للإجراءات المتشابهة سمات نجاح مستقرة: فهي معروفة سلفًا ولا حاجة لاختراعها من جديد مع كل طلب جديد. المعيار الخشن يضع إطارًا — إطارًا، لا حكمًا نهائيًا.
المرحلة الدقيقة: استخراج تفاصيل الحالة المحددة
الخطوة الثانية تتعامل مع تعليمة بعينها. تُستخرج منها إشارات موجزة — قيم محددة، ونطاقات عمل، وقيود جوهرية في هذه المهمة. هنا تحديدًا يتوقف المعيار عن كونه عامًا ويصبح خاصًا بهذه الحالة. المتطلبات التي لم يضعها المستخدم لا تظهر؛ والمتطلبات التي وضعها لا تُفقد.
هذا الفصل يزيل الاعتراض الرئيسي على المخططات الشاملة: التعميم يبقى، لكنه لم يعد يحل محل التخصيص.
النتائج: دون اتصال وفي التعلم المعزز
اختُبر AdaptRubric في وضعين. الأول — التقييم دون اتصال للمكافأة، أي مدى جودة تمييز المدقّق بين المسارات الناجحة والفاشلة. والثاني — التحسين المتصل بالتعلم المعزز، حيث تعمل المعايير كمصدر للإشارة لتدريب الوكيل.
الأرقام المعلنة: بميزانية صور مماثلة، ارتفع مؤشر F1 بمقدار 3.6 نقطة مقارنةً بمتوسط الحلول الأساسية، وبلغت الزيادة في نجاح تنفيذ المهام 4.23 نقطة. ويشدّد المؤلفون على أن الميزة تتكرر بثبات، ولا تعتمد على تجارب فردية موفقة.
ما الذي يغيّره هذا جوهريًا
يتوقف تقييم الوكيل عن كونه سؤالًا من نوع «هل المدقّق جيد أم سيئ». يصبح سؤالًا عن الإجراء: من صاغ المعايير لهذه المهمة تحديدًا، وعلى أي أساس. وطالما كانت المعايير تُستخرج ضمنيًا، كان من المستحيل تقريبًا فصل خطأ التقييم عن خطأ الوكيل نفسه — فقد كان كلاهما يبدو متطابقًا في التقرير النهائي.
يجعل النهج القائم على المعايير التكيفية الطبقة الوسيطة صريحة، وبالتالي يمكن فحصها ومناقشتها وتصحيحها بمعزل عن النموذج. وللتطوير في ذلك فائدة عملية أيضًا: إذا بُني المعيار وفق التعليمة، فإن تغيير صياغة المهمة يغيّر تلقائيًا طريقة تقييمها، دون إعادة كتابة المدقّق.
تبقى أسئلة مفتوحة — إلى أي مدى ينجح التوجيه في المهام الواقعة على تخوم العائلات، وكيف تتصرف المرحلة الدقيقة مع التعليمات الغامضة عمدًا. لكن الطرح نفسه يبدو أنفع من محاولة أخرى لجعل قالب شامل أكثر إتقانًا قليلًا.